AI 為什麼一本正經地胡說八道?幻覺的原理,和防不掉的那條底線
☰ 目錄
被 AI 的一本正經騙過的人,通常會問同一個問題:它明明不知道,為什麼不直說?這篇不教怎麼防(防法另有兩篇實作文,文末有連結),專門講清楚「為什麼」:幻覺不是 bug,是這類模型運作方式的必然產物。搞懂原理之後,就會知道哪些防法有效、哪些只是心理安慰,以及為什麼有一條底線永遠防不掉。本文工具與規格查證於 2026 年 11 月 12 日,引用的論文、官方文件與排行榜網址都附在文中。
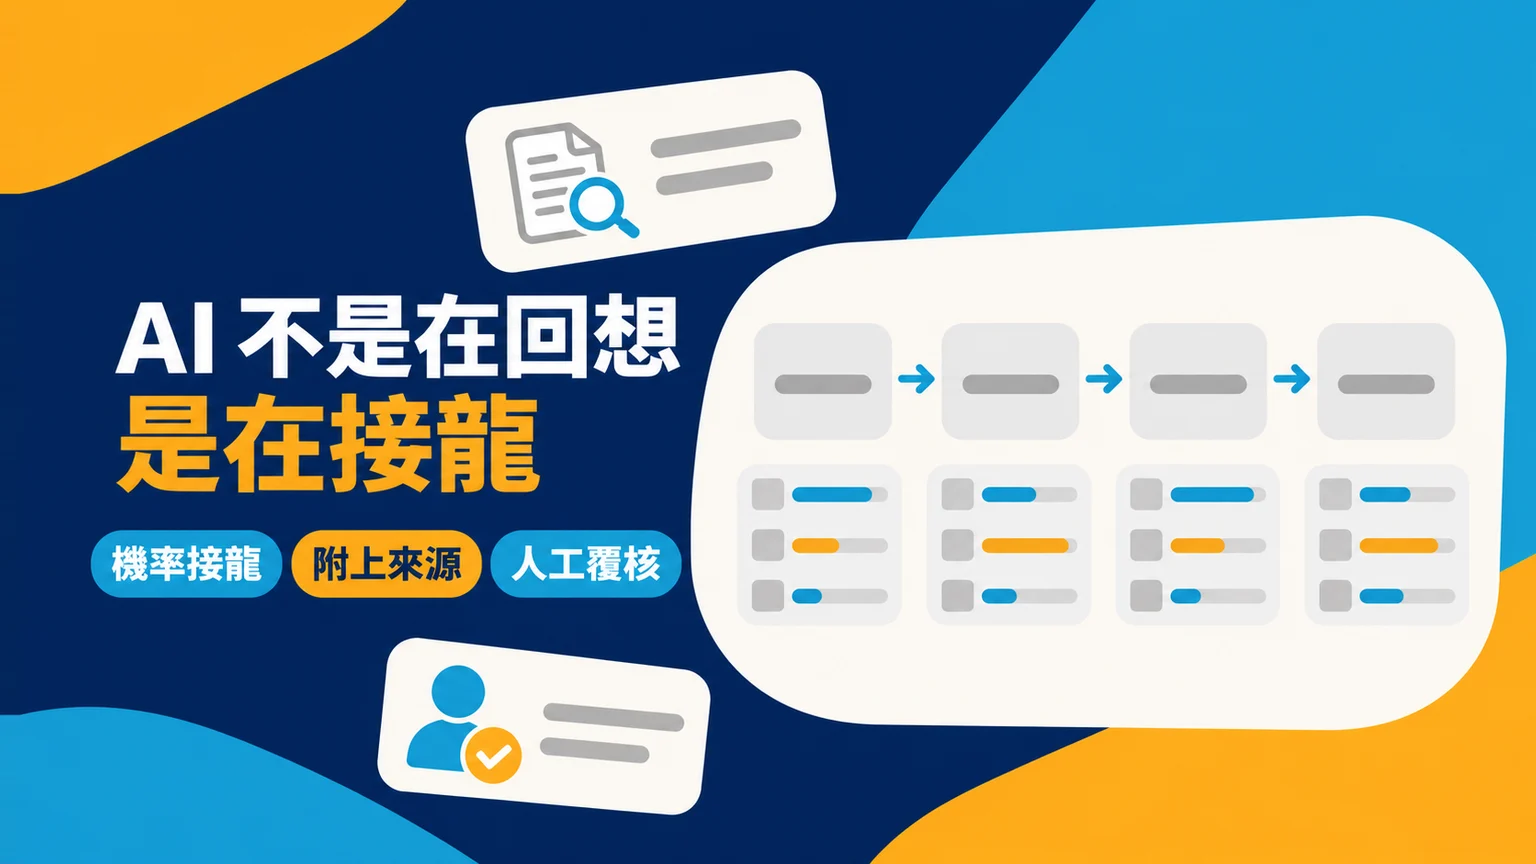
它不是在「回想」,是在「接龍」
語言模型不是查資料回想,而是逐字接龍,所以編造的內容在形狀上永遠是對的。
語言模型的本質是一個機率引擎:給它前面的文字,它算出下一個字最可能是什麼,一個字一個字接下去。它沒有一個「資料庫」在裡面查證,只有訓練時壓進參數裡的統計規律。所以問它「台北到高雄的高鐵要多久」,它答對不是因為查了時刻表,是因為訓練資料裡這個說法出現過夠多次,接龍接出正確答案的機率高。
這個機制解釋了幻覺最詭異的特性:它編造的內容在「形狀」上永遠是對的。假的論文有像模像樣的作者與年份,假的 API 有完全合理的參數名。因為模型學到的正是「這類東西長什麼樣子」,形狀對、內容錯,是接龍機制的正常輸出。
- 「我」或你、我們
- 「今天」或昨天、現在
- 「想」或要、覺得
- 「去」或來、到
- 「公園」或學校、商場
語言模型逐字接龍的機率機制示意:高機率路徑不等於事實正確
為什麼它不說「我不知道」
AI 不說「我不知道」,是因為訓練時給答案優於承認無知,而且它不知道自己不知道。
兩層原因。第一層在訓練:模型的目標是產出人類覺得好的回答,而在訓練回饋裡,流暢完整的回答分數通常比「我不知道」高,它等於被教育成「給答案優於承認無知」。第二層更根本:它其實不知道自己不知道。接龍引擎輸出每個字時都有信心分布,但「這整段話對應的事實是否存在」不在它的計算範圍內。問它 2026 年某冷門套件的版本號,它接出來的數字流暢度跟真實版本號一模一樣,它自己分不出差別。
第一層原因在 2025 年 9 月有了比較正式的說法。OpenAI 研究團隊的論文《Why Language Models Hallucinate》把幻覺拆成兩段:預訓練階段,模型只要分不出「錯誤陳述」與「事實」,統計壓力就會自然產生幻覺,這是分類錯誤,不是什麼神秘故障;後訓練與評測階段,主流排行榜的計分方式只看答對與否,猜錯跟棄權都是零分,猜對卻有分,於是模型被訓練成「優秀的應試者」,不確定時也要猜。作者的結論是解法在社會技術層面:改排行榜的計分方式,讓棄權不再比猜測吃虧,而不是再發明一套幻覺評測。這跟我們一線的體感一致:你很難靠提示詞逼它誠實,因為「誠實會扣分」是寫在它成長環境裡的。
- 只看答對與否主流排行榜
- 棄權也是零分跟猜錯一樣
- 優秀的應試者模型被這樣訓練
- 不確定也要猜
OpenAI 研究團隊論文《Why Language Models Hallucinate》對後訓練與評測階段的解釋
這也是為什麼「請你不要幻覺」這種指令幾乎沒用,而「不確定就標注出來」有一點用:後者至少把「低信心也照樣輸出」的預設,改成允許它在信心分布較平時停下來。Anthropic 的官方文件把「明確允許模型說不知道」列為減少幻覺的第一條基本技巧,並在結尾直接寫明這些技巧能顯著降低但無法完全消除幻覺,重要資訊仍要驗證。官方自己都把底線講在前面了。
幾乎沒用
- 「請你不要幻覺」
有一點用
- 「不確定就標注出來」
- 明確允許模型說不知道
減少 AI 幻覺的提示詞寫法:這些技巧能顯著降低但無法完全消除幻覺
什麼情況幻覺率飆高
AI 幻覺在訓練資料的邊緣、要求精確值、問題有錯誤前提這三種情境最兇。
照原理推,幻覺在三種情境最兇,跟我們一年來看自家客服機器人對話記錄的體感一致:
- 訓練資料的邊緣地帶。
冷門主題、太新的事件、小語種內容。資料裡出現次數少,統計規律就薄,接龍全靠腦補。中文技術內容問英文世界的冷門工具,是重災區中的重災區。
- 要求精確值的問題。
價格、日期、版本號、統計數字。這類答案「差一點就是全錯」,但對接龍引擎來說,差一點的數字機率分布幾乎一樣。我們寫文章時所有價格一律重新查證不信模型記憶,就是這個原因。
- 問題本身有錯誤前提。
問「Laravel 的 useState 怎麼用」(那是 React 的東西),它常常會順著你的錯誤前提編出一套答案,因為「順著問題接龍」永遠比「打斷你說前提錯了」機率高。
AI 幻覺率飆高的三種情境
實務上更有用的是反過來問:我手上這個問題,落在哪一類?送出之前花十秒對一下這份清單:
- 答案裡會不會出現一個「差一位數就全錯」的東西?金額、日期、版本號、法條編號、電話。有的話,這題一律要求附來源或自己查。
- 這個主題在中文世界常被討論嗎?如果連你自己都要翻英文文件才查得到,模型的統計規律大概也很薄。
- 問題裡有沒有夾帶你自己的假設?「既然 A 功能已經下架,那 B 怎麼辦」這種句型,模型多半不會回頭檢查 A 是不是真的下架。
- 這個答案會不會直接對外?客服回覆、報價、合約文字。會的話,不管前三題答案如何,都要進人工那一關。
幻覺率到底多高:排行榜的數字怎麼讀
Vectara 排行榜上幻覺率最低的模型仍有 1.8%,量的是資料在眼前時的轉述錯誤。
常有人問「現在的模型幻覺率是多少」,這個問題本身就有陷阱,因為幻覺率完全取決於你怎麼量。目前最常被引用的公開量測是 Vectara 維護的幻覺排行榜,做法是把同一批文件交給各家模型做摘要,提示要求只能用原文資訊、不得推論、不得引用內部知識,temperature 設為 0,再用它們自家的 HHEM 評估模型判斷摘要是否與原文一致,幻覺率等於 100 減掉一致率。重新查證當天(2026 年 11 月 12 日)看到的最後更新是 2026 年 10 月 22 日,榜上最低的模型幻覺率 1.8%,最高 24.2%,2024 年版的 GPT-4o 是 9.6%。
| 榜上最低的模型 | 1.8% |
|---|---|
| 2024 年版的 GPT-4o | 9.6% |
| 榜上最高的模型 | 24.2% |
防法為什麼有效:全部都是同一招
有效的防幻覺手段都是同一招:別讓 AI 憑記憶接龍,把真實資料塞進它眼前。
市面上有效的防幻覺手段,拆開看其實是同一個思路:別讓它憑記憶接龍,把真實資料塞進它眼前。RAG 是把你的文件檢索出來放進上下文;工具呼叫(Tool Use)是讓它查即時系統而不是猜;要求附來源是逼它的輸出跟眼前的資料對齊。實作面我們寫過完整的兩篇:Tool Use 與邊界設定與企業 RAG 實作,想動手直接看那兩篇。
- RAG文件放進上下文
- Tool Use查即時系統
- 要求附來源輸出對齊資料
各家平台也把這一招做成了現成功能。例如 Gemini API 的 Grounding with Google Search,開啟後模型會自己判斷要不要搜尋、搜完把來源網址與對應的文字區段一起回傳,讓你能做行內引用;依官方文件,Gemini 3 以上的模型每月有 5,000 次免費搜尋,之後每 1,000 次 14 美元。這類功能的本質還是同一招:把「憑記憶接龍」換成「讀眼前的搜尋結果接龍」。
把常見手段攤開來比,就看得出它們各自擋得住什麼、擋不住什麼:
| 手段 | 原理 | 擋得住 | 擋不住 | 適合的情境 |
|---|---|---|---|---|
| RAG(檢索增強) | 把你的文件找出來放進上下文 | 內部規章、產品規格、歷史文件這類「有正確答案存在」的問題 | 檢索沒找到時它照樣接龍;轉述仍可能引錯段落 | 知識庫問答、內部文件查詢 |
| Tool Use(工具呼叫) | 讓它查即時系統拿到真值 | 庫存、訂單狀態、價格、行事曆這類會變動的資料 | 工具沒覆蓋到的問題;工具回傳後的解讀錯誤 | 客服查單、帳務、排程 |
| 要求附來源或引文 | 逼輸出對齊眼前的資料,找不到就撤回 | 憑空捏造的數字與引述 | 引文本身被讀錯;資料不在上下文時無效 | 報告、摘要、對外文案初稿 |
| 允許說不知道 | 把「必須給答案」的預設關掉 | 信心分布很平時的硬猜 | 它自信但錯的情況,因為它分不出來 | 所有場景都該加,但別當主力 |
| 多跑幾次比對 | 不一致代表在腦補 | 邊緣地帶的隨機編造 | 訓練資料裡本來就錯的「穩定錯誤」 | 一次性查證、重要決策前 |
| 人工核准 | 讓錯誤有地方被接住 | 以上全部漏掉的那一條 | 人自己也沒看仔細 | 對外承諾、金額、法律文字 |
表格最右邊那欄是重點:沒有一列能單獨成為答案。我們在台灣企業 AI Agent 導入指南裡把 PoC 階段最常見的失敗歸因之一就寫成「只上了 RAG 就以為幻覺解決了」,結果檢索命中率一掉,模型回到憑記憶接龍,而且回答語氣跟命中時一樣篤定,沒人發現。
那條防不掉的底線:怎麼把它變成設計前提
就算資料都在眼前,AI 轉述仍可能出錯,所以高風險輸出永遠要留人工那一關。
底線在這裡:就算資料都在眼前,「讀資料並轉述」這個動作本身還是接龍,仍有小機率轉述錯。上一節排行榜的 1.8% 就是這個數字的實測版本。所以無論架構多完善,高風險輸出(對外承諾、金額、法律文字)永遠要留人工那一關。這不是技術不夠成熟,是機制天生如此,把這條當成設計前提,系統反而穩。
「留人工」聽起來像是放棄自動化,實務上不是。我們的做法是把輸出先分級,再決定每一級要不要人:
- 先列出系統會產出的每一種輸出。
不是「客服回覆」一個籠統類別,而是拆成查詢回覆、退換貨說明、報價、合約條款解釋、活動優惠說明,每一項分開列。
- 每一項標兩個分數:錯的機率、錯的代價。
錯的機率看前面那份四題清單;錯的代價看會不會對外、能不能撤回、有沒有金額。
- 代價高的,不管機率多低,一律進人工核准。
報價、合約、優惠承諾落在這裡。做法可以很輕:模型產出草稿,人按一下才送出。
- 代價低但機率高的,用工具與 RAG 把機率壓下來,並要求附來源。
查詢類回覆大多落在這裡。
- 代價低、機率也低的,直接自動化,但要留紀錄。
錯了可以事後回看,像我們在LINE OA 客服翻車那篇寫的,沒留對話紀錄的系統連出了什麼事都查不到。
- 每個月回頭看一次紀錄,把分級調整一遍。
模型換版本、知識庫更新、工具權限變動,都會讓原本的機率估計失效。
這套分級跟權限設計是一體的:代價高的輸出,往往也對應到不該全開的工具權限。哪些工具該接、哪些千萬別開,接上工作工具的權限指南那篇有完整的清單。
三種看起來有效、其實是心理安慰的做法
要求 AI 保證正確、看語氣判斷、讓同一個模型自己檢查,都只是心理安慰。
最後補三個我們常在客戶的系統提示詞裡看到、但照原理推就知道幫助有限的做法。
第一種:在系統提示詞裡寫「你必須保證正確」。這跟「不要幻覺」是同一件事。它沒有「正確性」這個開關可以打開,只有信心分布。要寫,就寫成可執行的動作:「不確定的地方標注出來」「找不到依據的句子刪掉」「只用提供的文件回答,不用你自己的知識」,這三句都是官方文件列的技巧,差別在於它們描述的是動作,不是結果。
第二種:看它的語氣判斷可信度。這是最危險的一種。接龍引擎的流暢與自信,跟正確率沒有關係,它編造的假論文跟引用的真論文語氣一模一樣。遇到語氣特別篤定的精確數字,反而要提高警覺。
第三種:讓同一個模型自己檢查自己。有一點用,但效果常被高估。它檢查時用的是同一套統計規律,原本分不出的錯,再看一次多半還是分不出。比較有效的版本是給它「不同的材料」去檢查:拿原始文件比對、拿工具查回來的真值比對,也就是又回到同一招,把真實資料放進它眼前。
把這三種心理安慰拿掉之後,剩下的做法其實不多,也不複雜:能接資料的接資料、能驗證的加驗證、剩下的留人工。這正是我們在AI 自動化開發與客製系統專案裡,在動手寫任何一行程式之前,先跟客戶一起畫出來的那張表。
延伸閱讀
常見問題
跟 AI 說「不要幻覺」有用嗎?
哪些問題最容易讓 AI 亂編?
RAG 能徹底解決幻覺嗎?
為什麼 AI 編的假資料看起來那麼真?
該怎麼在導入 AI 時把幻覺當成前提來設計?
這個主題的完整脈絡、選型比較與導入建議,都整理在指南裡。
訂閱免費電子報
把 AI 自動化、企業系統設計與 WordPress / Laravel 開發的真實案例和可直接照做的技巧,整理成電子報寄給你。只寄精選內容、不灌垃圾信,一鍵就能退訂。