GPT-6 Astra 和 Opus 5.5 怎麼選?獨立排行榜、價格與哪些工作交給誰
☰ 目錄 table-of-contents.md
老闆決定明年要替團隊買一套 AI 訂閱,會議上只問了一句:ChatGPT 還是 Claude?九月剛好兩邊都推出了新旗艦,OpenAI 在 9 月 3 日發表 GPT-6 Astra,Anthropic 在 9 月 22 日推出 Claude Opus 5.5。三週過去,各種排行榜與實測已經足夠讓人做判斷,只是答案不會是一句「選哪家」。
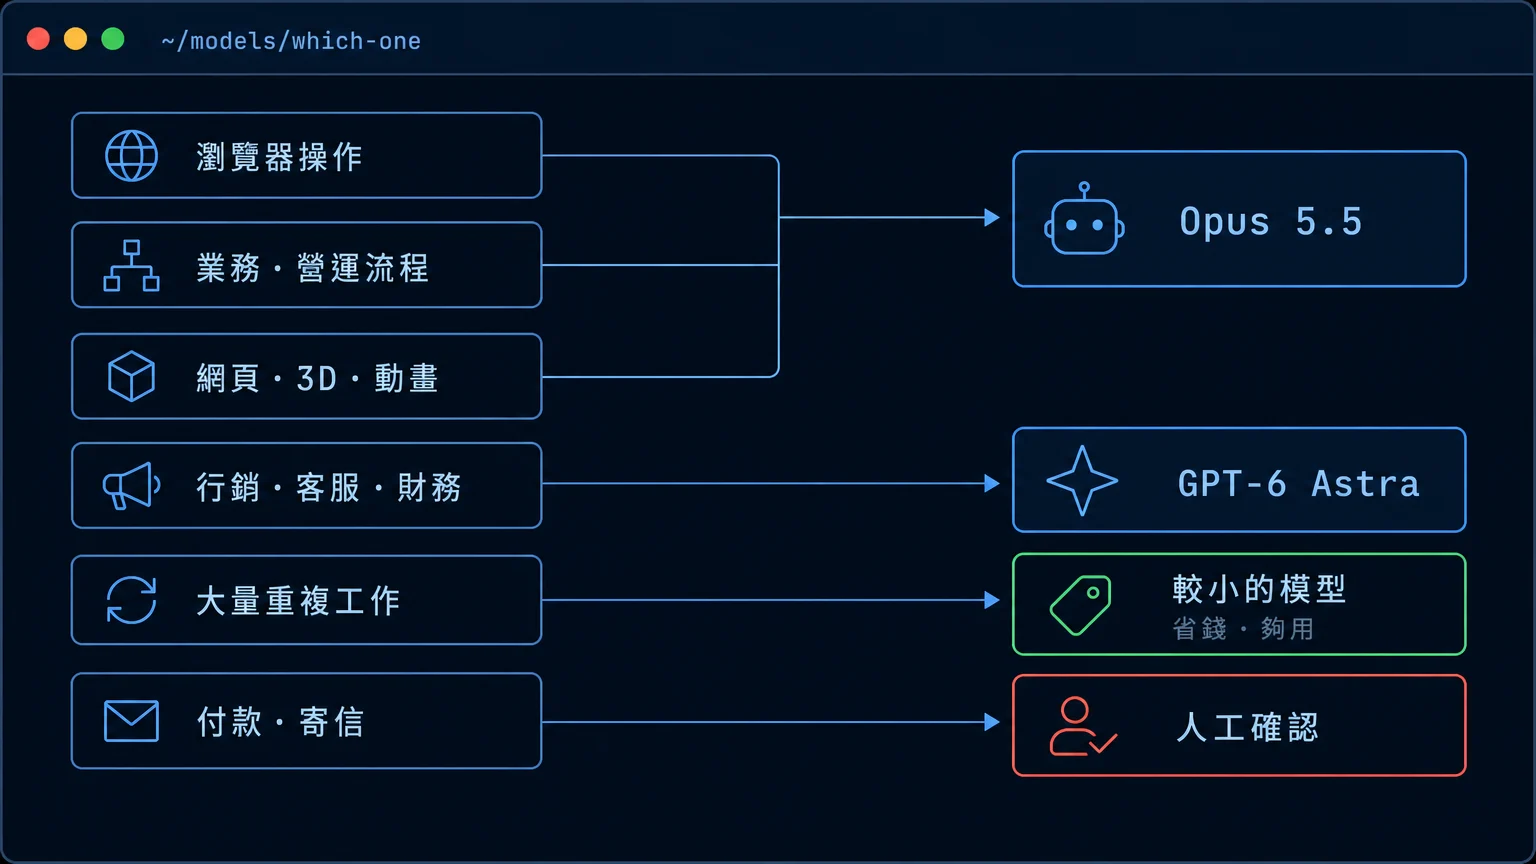
整理獨立排行榜與實測之後,大方向是這樣的:瀏覽器操作與業務、營運類流程,Opus 5.5 略勝,而且每個任務的成本比較低;行銷、客服、財務流程,Astra 仍然領先。要做出好看的東西,例如網頁、3D、動畫,Opus 5.5 多數時候贏,代價是 token 用得多;Astra 的特色則是省 token、步驟少。對大多數公司來說,團隊已經在用哪一套工具,往往比模型差那幾個百分點更重要,最好的做法是拿自己的十個流程兩邊都試。
先看基本差異
兩個模型的定位很接近,都是主打能長時間做事、能操作電腦的旗艦模型,差別在價格、方案與搭配的工具。
| 項目 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| 發表日期 | 2026 年 9 月 3 日 | 2026 年 9 月 22 日 |
| API 牌價(每百萬 token) | 輸入 10 美元、輸出 50 美元 | 輸入 4 美元、輸出 20 美元 |
| 上下文長度 | 約 105 萬 token | 100 萬 token |
| 訂閱方案 | Plus 只能在 Work 與 Codex 使用,Pro 額度較多 | Claude Pro、Max、Team、Enterprise |
| 主要工作介面 | ChatGPT 桌面 App 的 Work 與 Codex | Claude App、Claude Code |
| 電腦與瀏覽器操作 | 桌面 App 電腦操作、ChatGPT 瀏覽器擴充功能 | API 電腦操作、Claude in Chrome |
價格上,Astra 的單價是 Opus 5.5 的 2.5 倍。OpenAI 同一週也推出了便宜很多的 GPT-6 Sol(輸入 2 美元、輸出 10 美元)與 GPT-6 Luna(輸入 0.1 美元、輸出 0.5 美元)(Simon Willison 整理)。不過單價不等於每個任務的成本,這點後面會細講。
獨立排行榜:誰贏、贏多少
各家自己公布的跑分,測試環境不同,很難放在一起比;例如同樣是 OSWorld 電腦操作測試,OpenAI 公布 Astra 72.6%,用的是離線子集,Anthropic 公布 Opus 5.5 81.8%,又是另一套計分。比較可信的是第三方用同一套方法測兩家的排行榜,目前有三個值得看。
Zapier 的 AutomationBench 用 657 個模擬真實業務流程的任務,看最後的系統狀態對不對。9 月 27 日的版本裡,Opus 5.5 以 42.47% 排第一,每題成本 1.44 美元;Astra 以 41.4% 排第二,每題 1.73 美元。拆開看領域,Astra 在行銷、客服、財務三類任務仍是第一,業務與營運則是 Opus 5.5 領先。
Browserbase 的瀏覽器代理評測差距更明顯。兩者的準確率只差 2 個百分點,Opus 5.5 是 89%、Astra 是 87%,速度也差不多,都是五分多鐘一題;但每題成本 Opus 5.5 約 0.51 美元,Astra 約 3.07 美元,差了六倍。
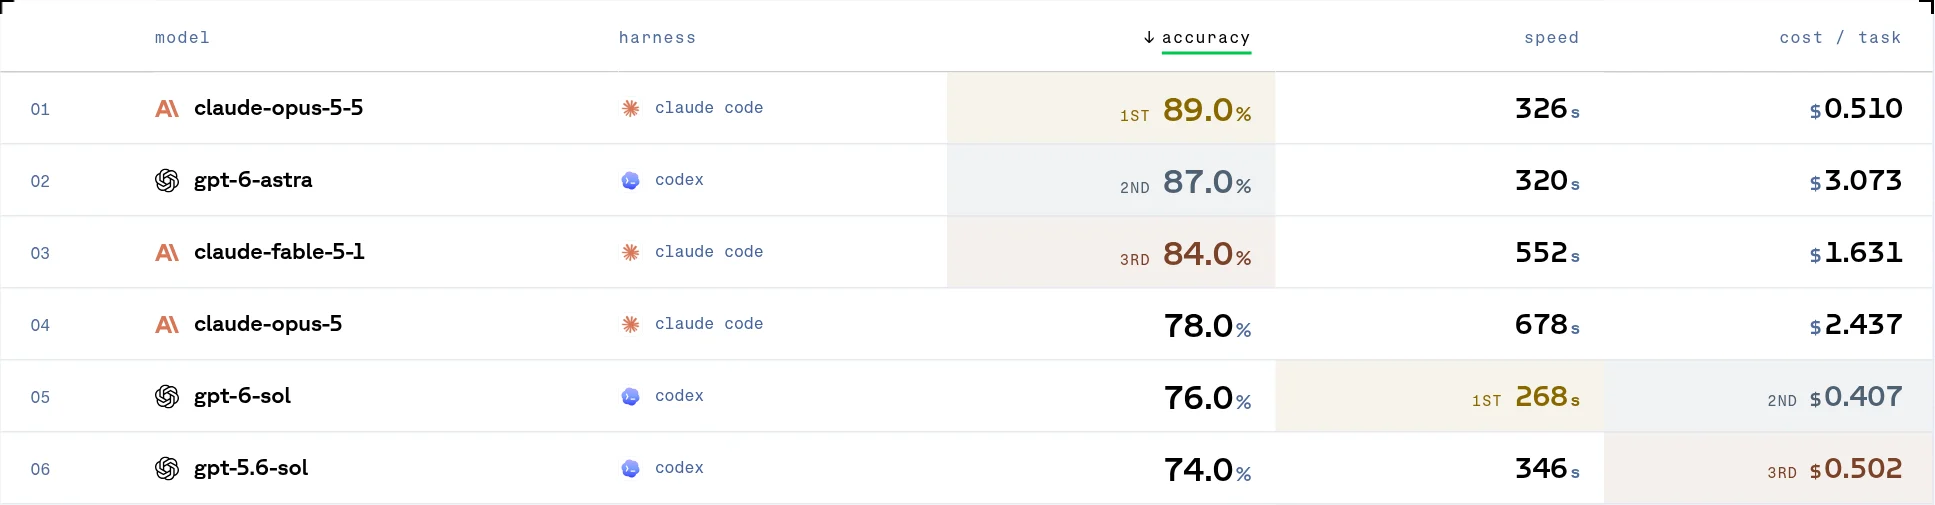
圖:Browserbase 瀏覽器代理評測:兩者準確率只差 2 個百分點、速度相近,但每題成本 Astra 約是 Opus 5.5 的六倍(截圖來源:Browserbase(Stagehand))
第三個是柏克萊大學團隊維護的 Agents' Last Exam,測的是更長、更專業的工作流程。Opus 5.5 搭配 Claude Code 的通過率 38.2%,Astra 搭配 Codex 是 34.2%;但 Astra 的總耗時少了約三十六小時,輸入 token 只用了約 5.8 億,Opus 5.5 則是 42 億。Astra 發表時宣稱在這個榜上第一,那是 Opus 5.5 推出之前的事。
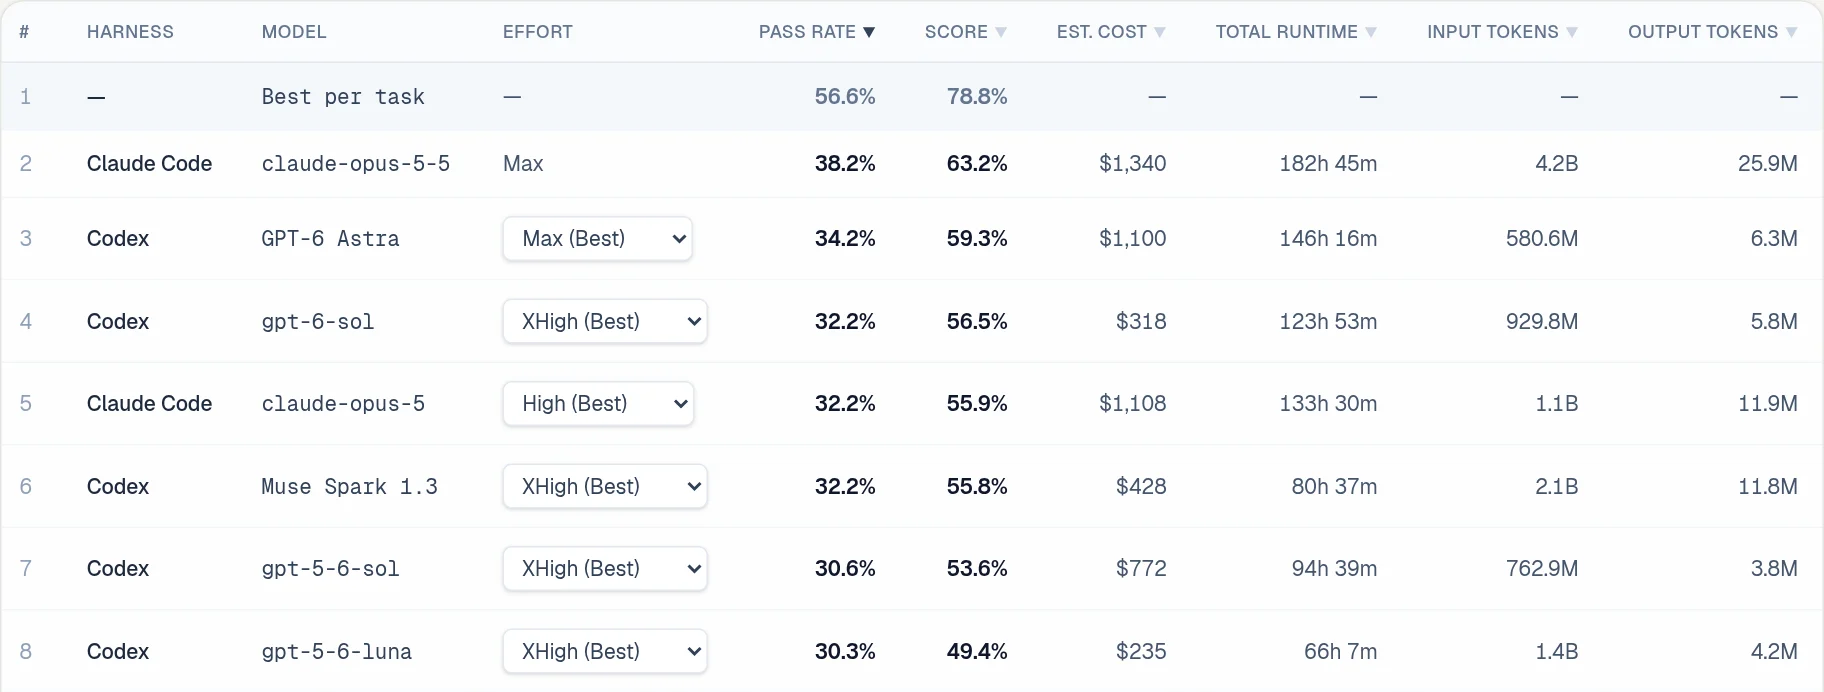
圖:Agents' Last Exam 專業工作流程排行:Opus 5.5 通過率較高,Astra 的總耗時與輸入 token 則明顯較少(截圖來源:Agents' Last Exam)
第三方機構 Artificial Analysis 的綜合智力指數也有類似變化:Astra 發表後與 Claude Fable 5.1 並列 53 分,Opus 5.5 推出後以 58 分拿下第一(Artificial Analysis)。這些差距都不大,而且排行榜每週都在變,拿來看趨勢可以,當成採購依據就太薄了。
要做出好看的東西:網頁、3D、動畫
這是兩者差異最明顯的地方。threejseval 讓各模型用同一個 prompt 做 15 種 Three.js 網頁 3D 場景,再由真人盲測投票。9 月 27 日的排名裡,Opus 5.5(High)以 2077 分第一,Astra(Medium)1902 分第二;Opus 贏了 15 題中的 10 題,艾菲爾鐵塔、收割機、窗簾這幾題則是 Astra 比較好。
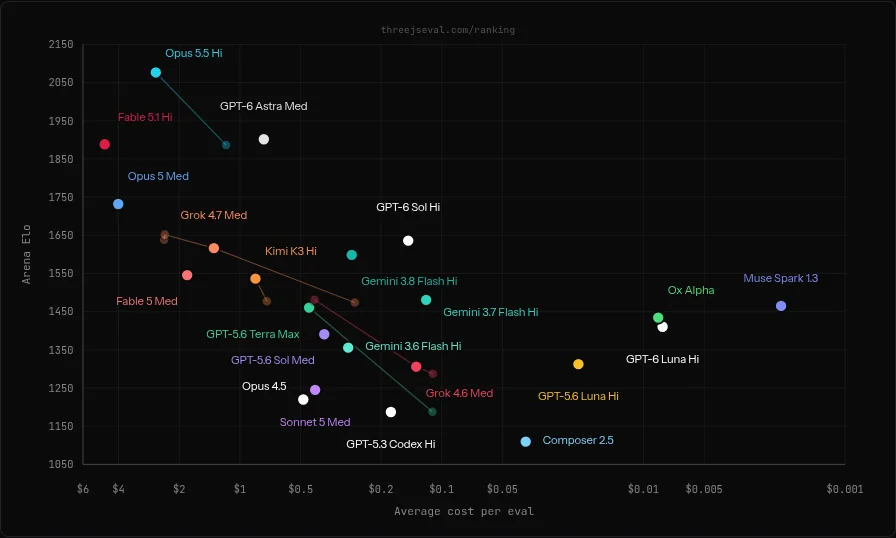
圖:threejseval 網頁 3D 盲測:Opus 5.5(High)分數最高、成本也高,GPT-6 Astra(Medium)以約三成的成本排第二(截圖來源:threejseval)
但看圖的橫軸就知道代價:Opus 5.5 每題平均用掉約 123 萬 token、2.61 美元,Astra 只用約 5.7 萬 token、0.76 美元。把 Opus 5.5 降到 Medium,分數 1886、每題 1.17 美元,跟 Astra 差不多,成本仍然高一些。
Blender 的同題測試也是一樣的模式。有人讓兩個模型都開最高效能做同一個簡單任務,成品「幾乎一樣」,Astra 花 43 分鐘、輸出 6.1 萬 token,Opus 5.5 花 1 小時 57 分、輸出 50.7 萬 token;另一位 3D 創作者做角色綁定與動畫時比較喜歡 Opus 的成果,但重建一個卡通場景時,認為 GPT-6 做得明顯比較好。寫過 Astra 長篇評測的 Matt Shumer 也有類似觀察:Claude 在視覺品味上仍然領先,Astra 則在後端與程式碼審查上比較強(原文)。產品發表影片方面,社群裡把 Opus 5.5 跟 Astra 並列比較的案例,多半偏好 Opus 的設計感,但都是單一使用者的非盲測比較。
實務上的建議是:要給客戶看、講究美感的產出,先試 Opus 5.5;量大、預算有限、只要夠用就好的,Astra 或 Opus 的 Medium 等級就夠了。還有一個提醒,Simon Willison 用 Opus 5.5 最高的 max 等級做一張向量圖,兩次都把 12.8 萬個輸出 token 全用在思考上、沒交出結果,一般工作開到 High 就好。
成本不是只看單價
Astra 的單價貴 2.5 倍,但它用的 token 少很多,所以實際每個任務的成本要看工作類型。上面幾個排行榜剛好說明了這件事:業務流程與瀏覽器操作,Opus 5.5 每題比較便宜;網頁 3D 這種會讓 Opus 大量思考的工作,Astra 反而便宜。
訂閱方案的額度也要一起看。Astra 在 Plus 方案每 5 小時大約只能用 5 到 45 則訊息,$200 美元的 Pro 方案還在 9 月 10 日因為需求太大暫停新訂閱。我們自己在〈GPT-6 Astra 強在哪裡〉的實測裡,讓 Astra 四個小時設完一套 CRM,同時也燒完 Pro 方案一週的額度。Opus 5.5 這邊,一位獨立開發者用 20 美元的 Claude 方案做了 8 支宣傳影片,用掉一週額度的 22%;另一位 Three.js 講師花 8 小時做一款島嶼遊戲,用掉 200 美元方案一週額度的 59%。這些都是個案,但方向很清楚:不管選哪家,重度使用都要預期額度會先用完,而不是帳單先嚇到人。
更省錢的做法是分工,不要所有事都丟給旗艦模型。我們在〈Jev 是什麼〉寫過自己的例子:官網導覽員原本讓寫回答的大模型同時決定要不要換頁,後來把這個判斷交給專門做決定的小模型,一次約 0.3 到 0.5 秒,訪客到達正確頁面的時間從九到十秒縮到四秒左右,寫回答才交給大模型。怎麼設計這種分工,〈LLM 帳單越用越貴怎麼救〉有完整做法。
安全與可控性
兩家都宣稱新模型更安全,但公開的比較數字不多。OpenAI 的 GPT-6 Astra 系統卡裡,外部紅隊 Gray Swan 的間接提示注入測試顯示,攻擊者重試 15 次時 Astra 約 8.5% 會被攻破,同一張圖裡 Anthropic 的上一代 Claude Opus 5 是 4.8%,Opus 5.5 沒有在這張圖裡。Anthropic 則說 Opus 5.5 是自家自動化行為稽核裡表現最好的模型,這是廠商自評。
操作層面,Astra 在 ChatGPT 裡預設會在重要動作前要求確認,系統懷疑它誤解指令時也會暫停任務;Anthropic 的 Claude in Chrome 則用分類器自動核准判斷為安全的動作。兩種設計各有取捨,但對企業來說結論相同:權限要自己設計,付款、寄信、刪資料這類動作不管用哪個模型都要人確認。權限怎麼分層,可以參考〈讓 AI Agent 接上你的工作工具〉。
情境選型:哪些工作交給誰
| 工作類型 | 建議先試 | 理由 |
|---|---|---|
| 瀏覽器操作、後台資料整理 | Opus 5.5 | 準確率相近,每題成本低很多 |
| 業務、營運流程 | Opus 5.5 | Zapier 分領域排名領先 |
| 行銷、客服、財務流程 | GPT-6 Astra | Zapier 分領域排名仍是第一 |
| 網頁、3D、動畫等要好看的產出 | Opus 5.5(High) | 盲測多數勝出,但 token 用量大 |
| 量大、預算有限的一般工作 | Astra 或較小的模型 | token 省、速度快,夠用就好 |
| 團隊已經在用 ChatGPT Work 或 Codex | GPT-6 Astra | 換工具的成本常大於模型差距 |
| 團隊已經在用 Claude Code | Opus 5.5 | 同上,技能與設定都能沿用 |
| 付款、寄信、刪資料 | 人工確認 | 任何模型都不該自動完成 |
工具鏈這件事值得多說一句。模型是跑在 Claude Code、Codex 這類工具裡面的,團隊累積的設定、skill 和工作習慣都綁在工具上。我們在〈三大 AI Coding Agent 完整比較〉比過這幾套工具的差異,建議先選工具,再在工具支援的模型裡挑;團隊的 skill 怎麼整理成可以帶著走的格式,可以看〈把同事煉化成技能包〉。
最後,排行榜是別人的題目。真正要決定之前,挑十個公司裡最常做、最花時間的流程,兩個模型各跑一輪,記下完成率、花的時間和額度,比任何排行榜都準。這樣的小規模試跑怎麼設計、怎麼算投報,〈AI 流程自動化的投報怎麼算〉有整理。如果想更進一步,讓系統依任務自動分派給不同模型,就是把 Agent 接進公司系統的題目了,可以參考我們的 AI Agent 開發。
整體來說,九月這兩個新旗艦沒有誰全面勝出。Opus 5.5 在多數獨立測試裡小幅領先、單價也便宜,Astra 則在特定流程與 token 效率上占優。選哪一個,最後要回到自己的工作、自己的工具和自己的預算。
資料來源與查證日期
- 官方:Anthropic:Claude Opus 5.5、OpenAI:GPT-6 Astra 系統卡、OpenAI Help Center:Astra 用量
- 排行榜:Zapier AutomationBench、Browserbase 瀏覽器代理評測、Agents' Last Exam、Artificial Analysis、threejseval
- 價格與實測整理:Simon Willison、Matt Shumer 的 Astra 評測
本文價格、方案與排行榜數字查證於 2026 年 9 月 27 日。排行榜為即時資料,新模型與重跑都會改變排名;各實測案例為作者自述,我們未重現。
延伸閱讀
常見問題
GPT-6 Astra 和 Claude Opus 5.5 哪個比較強?
Astra 比較貴嗎?
公司要怎麼決定用哪一個?
做網頁、3D 或動畫該用哪個?
這個主題的完整脈絡、選型比較與導入建議,都整理在指南裡。
訂閱免費電子報
把 AI 自動化、企業系統設計與 WordPress / Laravel 開發的真實案例和可直接照做的技巧,整理成電子報寄給你。只寄精選內容、不灌垃圾信,一鍵就能退訂。