沒有 API 的老舊系統,重寫還是用 OpenClaw 畫面自動化串接?
☰ 目錄
沒有 API,也能串接老舊系統嗎?
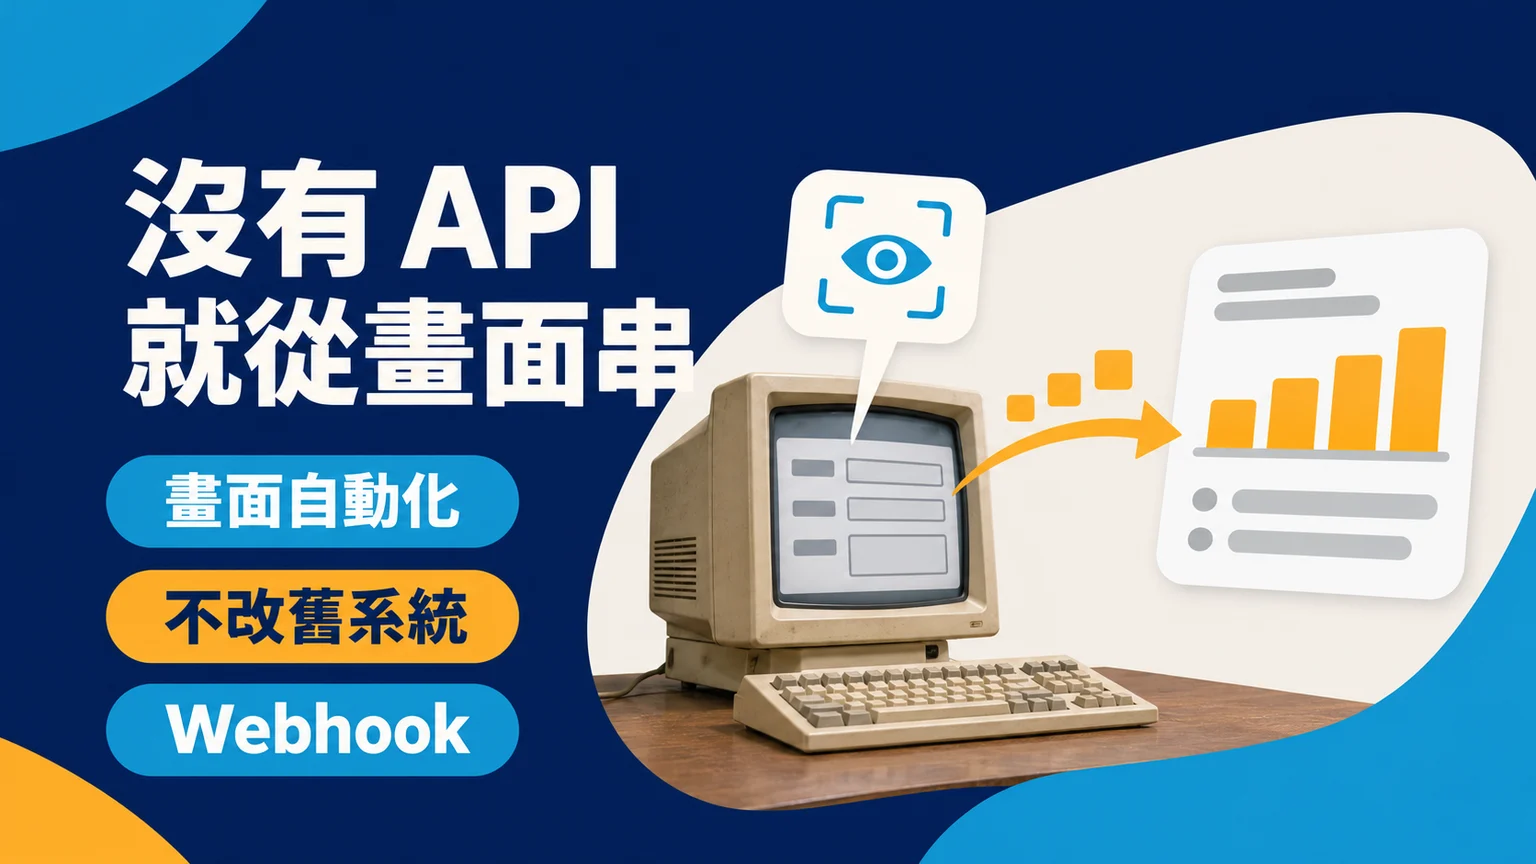
沒有 API 的老舊系統,可以用 OpenClaw 這類 AI 助理從畫面層讀取資料、操作介面,再把結果交給新系統,舊系統的程式碼不用改。
可以。當內部老舊系統(沒有 API、原廠已不維護、跑在過時瀏覽器或終端機介面)無法用傳統方式對接時,你不必砸大錢重寫或汰換它,而是改用「畫面層」自動化來搬運資料。本文用來示範的 OpenClaw 是一套開源、架在自己電腦或主機上的 AI 助理(MIT 授權,由非營利的 OpenClaw Foundation 維護)。它內建一個專門給 AI 操作的瀏覽器,能開分頁、讀頁面、點擊、輸入;較新的版本另有 computer 工具,讓支援影像的模型看著桌面畫面操作。所以在不改舊系統一行程式碼的前提下,它能把資料讀出來,再交給你的新系統。
換句話說:沒有 API,就用「擬人化操作」當作臨時 API。底下會說明為什麼老舊系統難搞、傳統 RPA 為何脆弱、OpenClaw 實際怎麼操作畫面、照官方文件做的設定步驟,以及導入時要注意的登入、資安與穩定性。
- 老舊系統沒有 API
- OpenClaw讀畫面、照指示操作
- 結構化資料例如 JSON
- 新系統接收資料
沒有 API,就用「擬人化操作」當作臨時 API。
在系統開發與企業數位轉型這行打滾多年,相信不少人都遇過這種讓人血壓飆升的經典情境:老闆或 PM 興沖沖地跑來說:「我們買了最新的 AI CRM 系統,只要把舊 ERP 的資料串過去就好,很簡單吧?」
簡單個大頭鬼。當你打開那套號稱「企業核心」的 ERP,發現它是一套跑在舊瀏覽器上、甚至還有藍底白字終端機介面的老古董。想找 API 文件?沒有這種東西。想請原廠開 API 端點?原廠不是收掉了,就是開出高額報價外加漫長的開發期。於是,數位轉型大夢往往就卡死在這座「資料孤島」前。
為什麼老舊系統是企業數位轉型最大的絆腳石?
老舊系統成為數位轉型的絆腳石,是因為它還堪用、不能停,卻無法被現代工具直接讀寫。
在談解法之前,先釐清「沒有 API」為什麼這麼致命。現代軟體架構(如 Headless 架構、微服務)大多建立在 RESTful API、GraphQL 或 Webhook 之上。API 就像系統之間的溝通橋樑;一旦沒了橋,資料就只能靠人工搬運,問題會像滾雪球一樣放大。
- 資料孤島效應:
舊系統的訂單無法即時同步到新的電子報或行銷系統,導致自動化流程在源頭就斷掉。
- 人工錯誤率高:
每天請人把 ERP 資料逐筆 Key 進新 CRM,不只浪費人力,只要打錯一個數字,下游報表就跟著全錯,而且很難追查。
- 技術債越滾越大:
為了屈就舊系統,團隊常被迫寫一堆「暫時性腳本」當補丁,久了變成沒人敢動、也沒人看得懂的維護黑洞。
關鍵在於:這些舊系統「還堪用、不能停」,但又「無法被現代工具直接讀寫」。多數企業卡在「全面汰換太貴、繼續手動太痛」的兩難。突破口,就在於換一個對接的「層次」。
傳統 RPA 為什麼那麼脆弱?
傳統 RPA 脆弱,是因為腳本綁死在固定座標或固定選擇器上,畫面一改版就找不到目標而報錯。
過去遇到沒有 API 的情況,工程師通常只能咬牙硬幹傳統的 RPA(Robotic Process Automation,機器人流程自動化)。RPA 的概念是錄製或編寫一連串的滑鼠點擊與鍵盤輸入,讓機器人模擬人在介面上的操作。立意很好,但實務上非常脆弱,原因在於它通常綁死在「固定位置」或「固定選擇器」上:
- 依賴座標或固定選擇器:腳本常記錄「點第 X、Y 個像素」或「點某個固定 id 的按鈕」。一旦按鈕位移、版型改版、或選擇器變動,腳本就找不到目標而報錯。
- 依賴硬等待(Hard Sleep):為了等畫面載入,傳統做法常用「固定睡幾秒」。網路快時浪費時間,網路慢時則還沒載入完就去抓,結果抓到空值或錯位資料。
- 缺乏判斷力:遇到非預期的彈窗、警告訊息或轉圈圈,腳本不會「想辦法」,只會卡死或繼續往下執行,造成錯誤擴散。
OpenClaw 如何在沒有 API 的情況下打通老舊軟體?
OpenClaw 操作網頁時先讀頁面結構快照,再用快照裡的元素編號點擊、輸入,不靠寫死的座標或選擇器。
OpenClaw 本身不是 RPA 工具,它是一個會用工具的 AI 助理:你用聊天的方式交代任務,模型決定要開哪個網頁、讀哪一段、按哪個按鈕。跟畫面自動化有關的有兩個工具,網頁系統用 browser,非網頁的桌面程式用 computer。
傳統 RPA 的做法
- 依賴座標或固定選擇器
- 依賴硬等待(Hard Sleep)
- 缺乏判斷力
OpenClaw 的做法
- 讀頁面結構快照再動作
- 元素失效就重拍快照
- 可等待指定內容出現
網頁型舊系統:browser 工具讀快照、照編號操作
OpenClaw 會開一個獨立的瀏覽器設定檔(預設名稱是 openclaw),跟你平常用的瀏覽器分開。依官方的瀏覽器工具說明,AI 拿到的是一個 browser 工具:snapshot 會回傳頁面的介面結構樹(AI 或 ARIA 兩種格式),裡面每個可操作的元素都有一個 ref 編號;act 再用這些編號去點擊、輸入、拖曳、選取。官方的說法是,這讓代理人重用擷取到的元素參照,而不必依賴容易壞掉的選擇器。
對工程師的意義是:你不必再去逆向那些充滿巢狀 <table> 的老舊 HTML,也不必為了沒有 id 的按鈕寫一堆選擇器。要只讀文字時,text 動作可以抽出頁面上的可見內文;要留存證據時,screenshot 能截整頁或單一元素。
非網頁的舊系統:computer 工具看桌面畫面
如果舊系統是 Windows 桌面程式或終端機視窗,網頁工具就幫不上忙。OpenClaw 的 computer 工具讓支援影像的模型看著桌面截圖操作滑鼠鍵盤。macOS 預設用 Peekaboo 執行,Windows 與 Linux 要啟用官方標示為實驗性質的 cua-computer 外掛。實驗性質的意思很直白:拿來處理正式資料前,要自己先跑過夠多次,確認它在你那套畫面上穩定。
畫面變了、載入慢了怎麼辦
官方文件寫得很清楚:畫面上原本抓到的元素消失時,綁定它的 ref 會失效,要先重新拍一次快照再重試。開啟網頁的等待時間預設 30 秒、上限 120 秒;頁面還在載入時,可以用 act 的 wait 動作等需要的內容出現,而不是固定睡幾秒。瀏覽器外掛啟用時,還會附一個 browser-automation 技能,教代理人處理快照、失效元素與「需要真人介入」這幾種狀況。
它的判斷力來自模型,所以遇到沒看過的彈窗,比較有機會照常理處理;但這也代表它不像傳統腳本那樣每次走完全相同的路徑。要放進每天跑的流程,請把它當成需要驗收的同事,而不是保證不出錯的機器。
實戰演練:用 OpenClaw 讀取老舊 ERP 數據
用 OpenClaw 讀內網 ERP,要先放行內網網址、人工登入一次,再用文字交代任務,必要時排程並把結果送出去。
舊版文章在這裡放了一段 YAML 任務設定,那個格式在官方文件裡找不到,所以拿掉了。OpenClaw 的任務是用自然語言交代的,沒有一份逐步點擊的腳本檔。下面是照官方文件整理的實際步驟,指令都是文件裡原本的寫法。
安裝並完成初始設定。macOS、Linux、WSL2 用官方安裝指令,再跑初始設定精靈,它會帶你設定模型、聊天頻道,並可裝成開機自動執行的背景服務:
curl -fsSL https://openclaw.ai/install.sh | bash openclaw onboard --install-daemon放行內網網址。老舊 ERP 多半在公司內網(例如 192.168 開頭的位址),而 OpenClaw 的瀏覽器預設會擋私有網段與內部位址,這是官方的 SSRF 防護。要在設定檔
~/.openclaw/openclaw.json裡明確放行。官方範例長這樣,把網域換成你的 ERP 主機名稱即可:{ browser: { ssrfPolicy: { dangerouslyAllowPrivateNetwork: false, allowedHostnames: ["*.example.com", "example.com", "localhost"], }, }, }另一個選項
dangerouslyAllowPrivateNetwork: true會放行所有內網位址,名稱裡就寫著 dangerously,能只放行單一主機就不要整段打開。人工登入一次。官方建議需要登入的網站由人在
openclaw瀏覽器設定檔裡手動登入,因為自動登入容易觸發防機器人機制、甚至鎖帳號。瀏覽器預設是無頭模式,登入前要切成有視窗:openclaw browser stop openclaw config set browser.headless false openclaw browser start openclaw browser open https://x.com這是官方範例的網址,換成 ERP 的登入頁即可。登入後的工作階段會留在這個設定檔裡,之後 AI 用同一個設定檔操作。
用文字交代任務。在聊天頻道或控制介面直接說:「打開 ERP 的今日出貨單,把表格整理成 JSON」。AI 會自己開頁、拍快照、找到表格、抽出資料。第一次請在旁邊看著它做,確認欄位對得上。
排程與送出結果。要每天固定跑,用 OpenClaw 的排程任務(automations)。任務跑完的結果有三種投遞方式,其中
webhook會把完成事件 POST 到你指定的網址,可以接到新系統的接收端。官方文件也提醒,webhook 投遞同樣有 SSRF 防護,預設拒絕內網與 loopback 位址;新系統如果也在內網,要另外規劃接收方式。任務連續失敗時,可以設定失敗通知送到聊天頻道。
跟傳統 RPA 腳本比,差別在你描述的是「要什麼資料」,而不是「點哪個座標」。代價是每一步都要經過模型判斷,速度比腳本慢,也會用到模型額度。資料量大、格式固定的批次搬運,等新系統上線後還是值得做正式的資料轉檔。
導入 OpenClaw 的三大優勢
用畫面層對接老舊系統的好處是成本低、上手快、不侵入舊系統,但舊系統大改版時流程仍要重新驗收。
用「畫面層」對接老舊系統,相較於重寫或硬接 API,通常有三個明顯好處:
- 成本效益高:
不必為了串接啟動一筆舊系統客製化專案,也不必因為「無法串接」而被迫提早汰換還堪用的核心系統。
- 上手速度快:
任務用文字交代,不用先寫完規格、等原廠排開發期,可以先拿一個小流程試做看成效。
- 無侵入性串接:
對舊系統而言,代理人就只是一個「不會喊累的操作員」,完全不需更動舊系統的任何程式碼或資料庫結構,系統穩定性不受影響。
打破限制,迎接 Agentic 自動化時代
舊系統還能開放 API 時,正規對接更穩定;API 不存在時,用 AI 代理人從畫面層搭過渡橋樑是務實解。
技術演進的目的,是解決真實世界的泥淖。「沒有 API 也能串接資料」對許多卡在資料孤島的企業而言,已經從一句口號變成可落地的選項。它不是要你放棄正規的 API 整合,如果舊系統還有機會開放 API,正規對接仍然更穩定、更可維護;但當 API 真的不存在、原廠也回不來時,以 AI 代理人從畫面層搭一座過渡橋樑,往往是兼顧成本、速度與穩定性的務實解。
延伸閱讀
- n8n、Make、Zapier 怎麼選?2026 自動化平台完整比較
- ERP 孤島終結者:2026 企業級 WordPress API 串接與資安實戰指南
- 你的網站只是個網站?WordPress API 串接戰略:LINE, HubSpot, n8n 整合模式大解析
- 不只是單向拋接!Laravel x HubSpot 進階戰術:打造企業級雙向、容錯、高效率的資料流引擎
- LINE Login x Laravel 串接實戰:用一鍵登入取代落落長的註冊表
OpenClaw 系列延伸閱讀
不熟 OpenClaw 的話,建議先看 OpenClaw 是什麼?完整解析。同類文章:
常見問題
老舊系統沒有 API,還能跟新系統串接資料嗎?
傳統 RPA 為什麼那麼容易出錯、那麼脆弱?
AI 視覺辨識為什麼比傳統座標式 RPA 更耐改版?
用 AI 代理人串接資料會有資安外洩疑慮嗎?
舊系統有兩階段驗證(2FA),還能自動登入嗎?
這個主題的完整脈絡、選型比較與導入建議,都整理在指南裡。
訂閱免費電子報
把 AI 自動化、企業系統設計與 WordPress / Laravel 開發的真實案例和可直接照做的技巧,整理成電子報寄給你。只寄精選內容、不灌垃圾信,一鍵就能退訂。