Agent 老是聽錯需求?10 組讓它一次做對的提示詞範例
☰ 目錄 table-of-contents.md
Agent 把事情做錯,十次有八次不是它能力不夠,是第一句話就給了它誤解的空間。它不會像同事那樣回頭問「你說的改一下是指哪裡」,它會直接挑一個它覺得合理的解讀開始做,然後你看到成品才發現方向全歪。這篇整理 10 組我們接案與內部實際在用的提示詞,每組都附「為什麼這樣講有效」,你可以直接抄去改。本文工具與規格查證於 2026 年 10 月 15 日。
共通原則只有一條,先講在前面:把「驗收標準」講出來,而不是把「感覺」講出來。話裡有可以檢查的條件,它就會照著檢查;只有形容詞,它就自由發揮。這不是我們自己的發明,Anthropic 的提示詞最佳實踐開頭就寫了一條黃金法則:把提示詞拿給一位不清楚脈絡的同事看,他會困惑的地方,模型也會困惑。文件還建議把模型當成「很聰明、但剛報到的新同事」,你講得越精確,結果越好。下面十組,本質上都是在幫那位剛報到的同事把話講清楚。
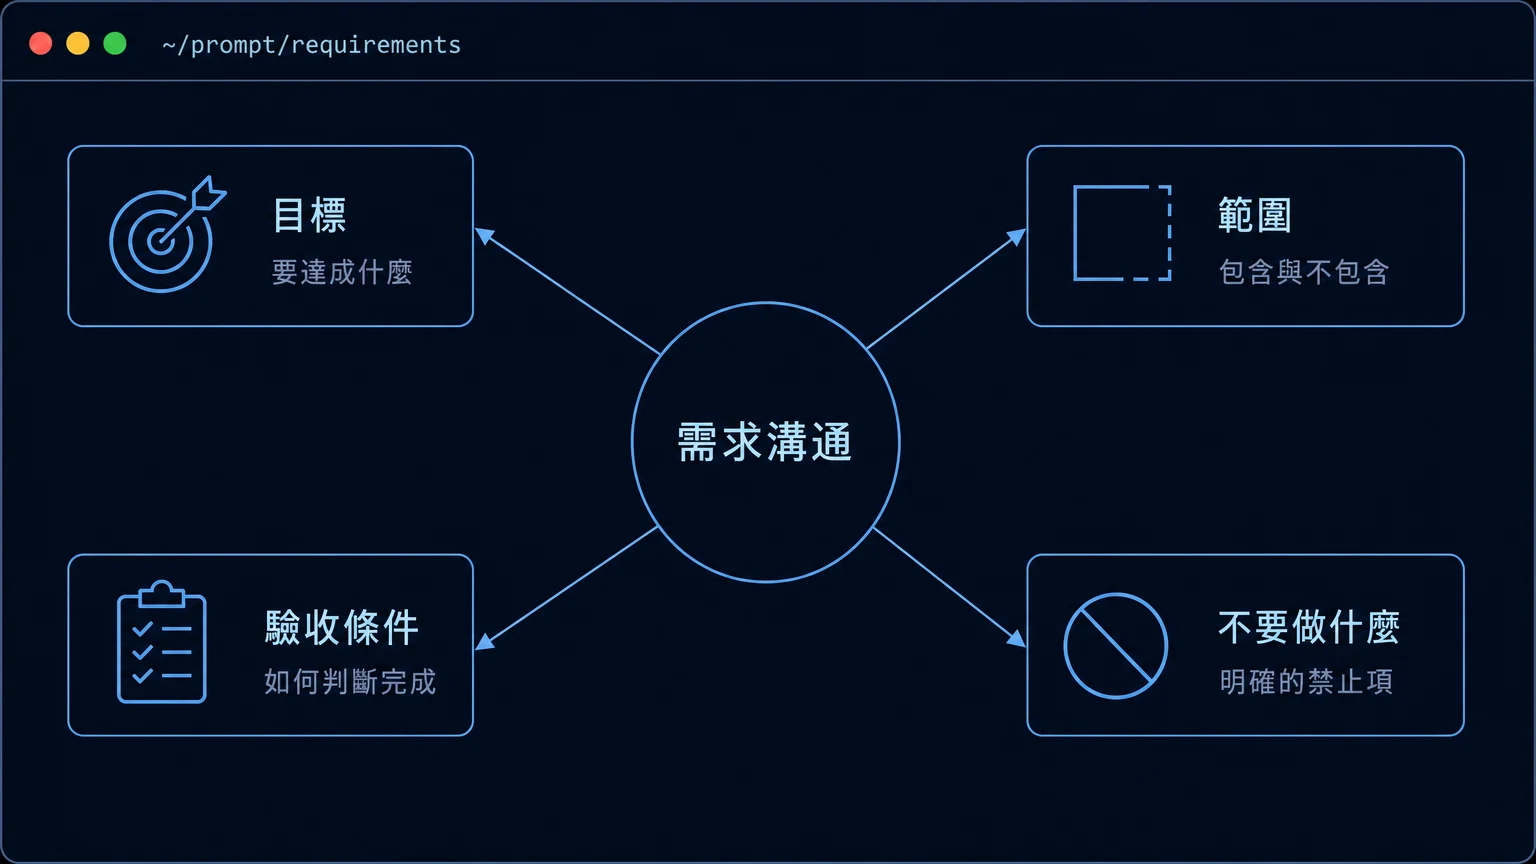
開工前:把需求釘死的四組
1. 反向面試。「先不要動手。針對這個需求,把所有模糊的地方列成問題問我,一次全部列出來,我回答完你再開始。」這招把「它猜」變成「它問」,一次擋掉大半誤解。社群爆紅的 grill-me 就是把這件事做成一鍵,我們之後有專文拆解。
什麼時候該用:需求是口頭講的、還沒寫成文件,或者這件事做錯要重來的成本超過半天。會卡在哪:它有時一口氣丟十幾個問題,其中一半翻一下專案檔案就有答案,等於把查資料的工作推回給你。我們的做法是在那句後面再補一句「能從現有檔案或對話紀錄找到答案的不要問我」,問題數通常掉到三到五個,而且每一個都是真的要你拍板的決定。grill-me 的作者 Matt Pocock 在 GitHub 上的 skills 專案(MIT 授權,查證當天約 29 萬顆星)用的也是同一套設計:一次只問一題、每題附建議答案、能自己從程式碼查到的就不問。
2. 複述確認。「開始之前,用你自己的話把這個任務的目標、範圍、你打算怎麼做講一遍給我聽。」它複述歪了,你三十秒就能糾正;它做完才發現歪,你付出的是整段重來。
什麼時候該用:任何超過三句話的需求都值得。會卡在哪:它複述得很流暢,你就以為它懂了。流暢不等於正確,重點是看它複述的「範圍」有沒有多出你沒講的東西,或少掉你以為很明顯的東西。我們的做法是要求它用「目標、範圍內、範圍外、打算怎麼做」四段式複述,少一段就補問一次。範圍外那段最常露餡,它常常把你沒提到的事默默算進去。
3. 給反例。「我要 A,但不要做成 B 那樣。上次那版的問題是 C。」只講要什麼,它的想像空間還是太大;把不要什麼講出來,範圍立刻收斂。反例比正面描述更省字也更準。
反例最好的來源是上一版成品。「不要像上次那樣把所有欄位都塞進同一張表」比「表格要簡潔」好用十倍,因為它有具體的對照物。Anthropic 的文件把範例列為引導輸出格式與語氣最可靠的方式,建議給三到五個;我們的經驗是,正例一個、反例兩個的組合最省字,因為反例會自動排除一整片錯誤方向,正例只能指出一個點。
4. 指定停損點。「如果做到一半發現需要動到 X,先停下來問我,不要自己決定。」這條是給它畫紅線:哪些變更超出授權。搭配權限設計一起用,紙上一條、系統一條,雙保險。
停損點要寫的是「動作」不是「感覺」。「覺得不對就停」它判斷不了;「需要新增資料表、刪除檔案、呼叫付費 API 之前先停」它就做得到。這條在接了工具的 Agent 上特別重要,它能動的東西越多,紅線就越要寫在它看得見的地方。我們自己在排程跑的自動化裡,每一個會寫入的動作前面都有這種句子,不是不信任它,是一旦出錯沒有人在旁邊按停。
進行中:讓它不跑偏的三組
5. 要求分段交付。「先做第一部分給我看,我確認方向對了你再繼續。」大任務一次做完再驗收,錯了成本最高;切成段,每段都是一個糾偏機會。
段怎麼切:以「你看得懂的中間產物」為單位。寫文章就先給大綱,做系統就先給資料結構,做報表就先給一筆範例資料。切錯的典型是用「做到一半」當分段點,半成品你看不出對錯,等於沒驗收。另一個常見的錯是段切太細,每段都要你確認,反而比自己做還慢;一般的經驗是三到四段,第一段一定要是最容易看出方向對不對的那一段。
6. 讓它標注不確定。「你不確定的地方直接標出來寫『不確定』,不要用看起來很有把握的語氣猜。」AI 的預設是流暢優先,這句話給它「承認不知道」的許可,幻覺會少很多。
Anthropic 在降低幻覺的官方文件裡把這招列在第一條:明確給模型「說我不知道」的許可,就能大幅減少錯誤資訊。同一份文件還有兩個進階做法,處理長文件時先要它逐字引用原文、再根據引用做分析;做完之後要它替每一個主張找到支持的引述,找不到就撤回那句話。這三招我們在整理長文件時會一起用,效果比單獨用任何一招好。原理層的說明見用 Tool Use 與邊界設定根治幻覺那篇,文件最後也提醒,這些技巧能大幅降低幻覺但不能完全消除,關鍵決策還是要自己驗證。
7. 給量的標準。「標題控制在 25 字內」「列 5 點,每點一句話」「預算上限是三萬」。所有能量化的都量化,「精簡一點」「專業一點」這種形容詞,十個人有十種解讀,AI 也一樣。
下面這張表是我們把常見的形容詞翻譯成可檢查條件的對照,右邊那欄才是它真的能執行的東西:
| 原本想講的感覺 | 翻成可以檢查的條件 | 它會怎麼自我檢查 |
|---|---|---|
| 精簡一點 | 每點一句話,全文 300 字內 | 數句數、數字數 |
| 專業一點 | 不用驚嘆號,數據附來源,不用「超」「很」這類程度副詞 | 逐條掃一遍有沒有違反 |
| 親切一點 | 每段開頭不用術語,結尾給一句下一步該做什麼 | 對照每一段的開頭與結尾 |
| 完整一點 | 涵蓋指定的五個小標,每個小標至少兩段 | 比對小標清單 |
| 看起來高級 | 只用兩種顏色,字級不超過三種,區塊間距不小於 24px | 量測數值 |
寫設計需求時這張表特別好用,AI 網頁設計提示詞那篇有整套視覺上的版本,從配色到間距都翻成了數字。
驗收時:抓出問題的三組
8. 逐項驗證。「把我原本的要求逐條列出來,每一條後面寫你做了什麼、在哪裡可以驗證。」整批一起驗會被做對的部分蓋過去,逐條對才會露出漏掉的那項。
這招跟前面提到的「替每個主張找引述、找不到就撤回」是同一個邏輯,只是對象從事實換成需求。我們的經驗是,它列出來的清單裡最值得看的是「在哪裡可以驗證」那一欄,寫得出具體位置的通常真的做了,寫「已處理」「已完成」沒有位置的,八成就是漏掉或做得不完整的那一項。
9. 自我挑錯。「假設這份成品有三個問題,會是哪三個?」它挑自己毛病的能力意外地好,常常第一個就講中你心裡那個疙瘩,順便省下你組織批評的力氣。
要注意的是,它挑出來的三個不一定是你最在意的三個,但幾乎每次都有一個是你沒想到的。挑完之後不要直接叫它全部修,先判斷哪些是真問題,不然它會為了「修問題」把原本對的地方也改掉。
10. 換角色重看。「用一個第一次看到這東西的客戶的角度重讀一遍,哪裡會看不懂?」寫的人有盲區,AI 也有;換視角指令能把它從「作者模式」切到「讀者模式」,抓出的問題跟第 9 組不重複。
角色要具體。「客戶」太籠統,「第一次用這套系統、用手機看的門市店長」才逼得出真的盲區。角色越像真實讀者,它模擬出來的困惑就越接近上線後會收到的客訴。
十組速查表
把十組按階段整理成一張表,印下來貼在螢幕旁邊的那種:
| 階段 | 組 | 一句話版本 | 最適合的情境 |
|---|---|---|---|
| 開工前 | 1 反向面試 | 先列問題問我,回答完再做 | 口頭需求、重做成本高 |
| 開工前 | 2 複述確認 | 用你的話講一遍目標與範圍 | 任何超過三句話的需求 |
| 開工前 | 3 給反例 | 要 A,不要像 B,上次問題是 C | 有上一版成品可對照 |
| 開工前 | 4 停損點 | 要動到 X 之前先停下來問 | Agent 接了工具、會寫入 |
| 進行中 | 5 分段交付 | 先做第一部分給我看 | 任務超過一小時 |
| 進行中 | 6 標注不確定 | 不確定的直接標出來 | 牽涉事實、數據、法規 |
| 進行中 | 7 量化標準 | 字數、點數、上限寫成數字 | 所有有「一點」的形容詞 |
| 驗收時 | 8 逐項驗證 | 逐條列要求,寫在哪驗證 | 需求超過五條 |
| 驗收時 | 9 自我挑錯 | 有三個問題會是哪三個 | 成品看起來沒問題時 |
| 驗收時 | 10 換角色重看 | 用具體讀者的角度重讀 | 要給外部人看的東西 |
組合起來的樣子
實務上不是每次十組全上。小任務用 2 加 7(複述加量化)就夠;大案子開場用 1(反向面試),中途 5 加 6,收尾 8。我們自己的習慣是把常用組合寫進 Skill 變成固定流程,不用每次重打,做法見 Skills 入門;要更完整的需求訪談流程,需求訪談與 AI 規劃那篇有接案場景的版本。
為什麼寫成 Skill 比存在筆記裡好:Anthropic 的 Agent Skills 文件把 Skill 定義成放在檔案系統裡、需要時才載入的指令包,跟一次性的提示詞最大的差別就是「寫一次、之後自動用」。文件特別強調 description 欄位要同時寫「它做什麼」和「什麼時候該用」,因為模型是靠這段文字判斷要不要啟用。換句話說,你把「反向面試加停損點」寫成一個 Skill,描述寫「接到口頭需求、還沒寫成文件時使用」,之後只要情境符合它就會自己先問再做。把這種判斷從個人習慣變成團隊共用的檔案,就是把老鳥的判斷挖成 Skill那篇在講的事。
讀者常問的三個情境
一般對話的 ChatGPT 或 Claude 也適用嗎
適用,而且前七組在一般對話裡一樣好用。差別在 Agent 會動手,它誤解之後不只是回你一段錯的文字,而是改了檔案、發了信、建了資料。所以在 Agent 上,第 4 組停損點跟第 8 組逐項驗證的權重要拉高;在一般對話裡,第 2 組複述跟第 7 組量化就夠應付大多數情況。
中途發現它已經偏了,是重開還是拉回來
先判斷偏在哪一層。偏在「理解」,例如它把改首頁理解成改全站,那就重開,因為後面每一步都建立在錯的前提上,拉回來的成本比重來高。偏在「執行細節」,例如方向對了但用錯元件,那就用第 3 組給反例拉回來。判斷的方法很簡單,要它用第 2 組重新複述一次目標,複述還是錯的就重開。這也是為什麼我們建議大任務一開始就複述,少一次重開省下的額度,遠超過複述那幾句話的成本,AI 額度老是不夠用那篇算過這筆帳。
同一套指令每週都在重打,是誰的問題
是流程的問題,不是提示詞的問題。我們在GPT-6 Astra 評測那篇寫過,四小時設完 CRM 也四小時燒完一週額度,燒掉的額度裡有一大半就是重複講同一件事。同一句話打超過三次,就該變成 Skill;團隊裡每個人下的指令品質落差很大,就該有一份共用的範本。提示詞能解決溝通問題,解決不了流程問題,把流程固定下來,正是我們 AI 自動化開發在幫企業做的事。
延伸閱讀
常見問題
這些提示詞每次都要全部用上嗎?
為什麼 AI 不像人一樣主動問清楚?
「專業一點」「精簡一點」這種指令為什麼沒用?
怎麼降低 AI 一本正經亂編的機率?
驗收的時候該怎麼問,才抓得出問題?
這個主題的完整脈絡、選型比較與導入建議,都整理在指南裡。
訂閱免費電子報
把 AI 自動化、企業系統設計與 WordPress / Laravel 開發的真實案例和可直接照做的技巧,整理成電子報寄給你。只寄精選內容、不灌垃圾信,一鍵就能退訂。