DeepSeek V4.1 Flash 台灣公司能用嗎?社群實測與資料風險
☰ 目錄 table-of-contents.md
10 月 17 日,DeepSeek 把 V4.1 Flash 換成 1017 版。官方給的說法很短:跑分更高,做完同一件事更快、輸出更短,價格不變。Hacker News 那串討論累積了 610 分、532 則留言(10 月 18 日早上時事雷達抓取時的數字),吵最兇的卻不是跑分,是兩件很實際的事:它為什麼用起來比跑分更高的模型順手,以及送出去的請求到底落在哪個國家。
第二件事,台灣公司要比美國工程師更早想清楚。我們的判斷是這樣:官方 App 與網頁的資料依隱私權政策存放在中國,公司文件與客戶個資不要放進去;官方 API 的條款適用中國大陸法律,只適合送已經公開、不敏感的內容;想用它又要把資料留在自己手上,路只有一條,就是下載 MIT 授權的權重自己跑,代價是很大的記憶體與維運。公務機關、公立學校、關鍵基礎設施提供者與政府捐助的財團法人,2025 年起就已經被要求不得使用,接這些單位案子的團隊也要先問清楚。
這篇寫在更新後第二天,判斷以官方文件、政府公告與社群實測為主,引述的留言都附原文連結。本文價格與規格查證於 2026 年 10 月 18 日,之後若有變動以官方頁為準。
DeepSeek V4.1 Flash 1017 更新了什麼:官方數字與查證
這是一次小改版。依官方更新紀錄,V4.1 Flash 在 9 月 10 日推出,是 DeepSeek 新架構家族裡最小的模型,原生支援看圖;10 月 17 日的 1017 版沒有改名,官方把重點放在「效能與成本的帕雷托改進」,也就是同樣的任務跑更短的時間、吐更少的字,所以更快也更省。跟採購與導入有關的事實整理如下:
- 規模與授權:Hugging Face 模型頁標示 763B 參數、上下文 100 萬 token,授權是 MIT License,權重可以下載,也可以商用。
- 跑分:同一頁列出跟上一版 Flash 的比較,HLE(不用工具)從 36.8 升到 42.6,Terminal-Bench 4.0 從 31.2 升到 42.3,DeepSWE v1.1 從 74.2 升到 77.0。進步最多的是在終端機裡操作的 Agent 任務,這些都是 DeepSeek 自己公布的數字。
- 上線範圍:官方公告寫網站、App、API 同步換上新版。
- 新的付費工具:同一份公告提到伺服器端的搜尋與擷取(Search & Fetch)工具,每 1,000 次呼叫 0.75 美元,台北時間 11 月 1 日零點起開始計費。
有使用者在留言裡提醒,官方比較圖拿來比的是 OpenAI 的 Sol 5.6,最新版其實已經是 6.1(gregwebs 的留言),看比較表時記得這一點。
價格:台灣的上班時間剛好落在尖峰
依官方價格頁,API 名稱 deepseek-flash 現在對應的就是 1017 版,上下文 100 萬 token、單次最多輸出 384K token。價格分尖峰與離峰,離峰是尖峰的一半:
| 計費項目(每百萬 token,美元) | 尖峰 | 離峰 |
|---|---|---|
| 輸入(命中快取) | 0.006 | 0.003 |
| 輸入(未命中快取) | 0.3 | 0.15 |
| 輸出 | 1.2 | 0.6 |
尖峰時段是 UTC 週一到週五的 01:00 到 04:00 與 06:00 到 10:00(中國國定假日除外),換成台北時間就是早上 9 點到中午 12 點、下午 2 點到 6 點。台灣公司的上班時間幾乎整段都在尖峰,午休 12 點到 2 點、晚上與週末反而是離峰。要大量跑摘要、分類這類不急的批次工作,排到晚上就是半價。
同一個 API 名稱,背後換了一個模型
更新紀錄寫得很清楚,呼叫方式還是 deepseek-flash,跟之前一樣。好處是不用改程式就升級;壞處是你的系統昨天跟今天接的其實是不同的模型,紀錄也沒有說 9 月那一版還能不能單獨呼叫。這件事放到後面談,因為它不只發生在 DeepSeek。
Hacker News 五百多則留言在吵什麼
主討論串加上另一串 Apple 機器學習研究的討論(有人在裡面回報自己的機器跑 DeepSeek 的數字),讀下來大致是三種聲音:說它用起來順手的、在意請求送去哪裡的、想把它搬回自己機器上跑的。
跑分沒有贏,用起來卻比較順手
跑分上 DeepSeek 沒有贏過 Sol 和 Gemini,但這陣子輪流用下來,我開始懂為什麼大家覺得它「用起來」好很多。第一是供應商給的輸出速度和第一個字出來的時間,它做事很快,品質也相當好,你不會一直在等 Agent 跑完。第二是開放,看得到它的思考過程,也不會莫名其妙被資安審查擋下來。(原文:Being able to see the CoT and not being randomly blocked for cyber review.)
(Hacker News 使用者 OsrsNeedsf2P 的留言,原文)
這則留言拿到最多回覆。有趣的是他最後說下一個訂閱大概會選 Z.ai(做 GLM 系列模型的公司),底下馬上有人問他誇了三段 DeepSeek,怎麼去訂別家。另一位使用者把「順手」講得更具體:
我覺得它好用,是因為它不會想太聰明。我叫它做事,它寫出來的就是一般工程師會寫的程式碼,我還是能照自己腦中的分層去蓋軟體,抽象要放在哪裡也還是我說了算。(原文:it actually generates code that a developer would write.)
(Hacker News 使用者 Philip-J-Fry 的留言,原文)
速度這件事我們有切身體會。我們在〈jev-router 是什麼〉寫過,官網導覽員小浪原本每次回答前會先想 1 到 3 秒,把思考強度調低之後,第一個字從最慢 4.3 秒提早到 1.9 秒內,回答品質沒有差別。使用者感受到的好不好用,很大一部分是等待的時間,跑分表上看不到。這也是為什麼同一張排行榜,拿去問每天在用的工程師,答案常常不一樣。
真正的分歧:請求送到哪個國家
提醒一下,opencode 會把 DeepSeek 的請求送到中國。(原文:Note that opencode routes deepseek requests to China.)
(Hacker News 使用者 abc42 的留言,原文)
opencode 是一套在終端機裡用的開源 AI 寫程式工具。這句話底下吵成一大串。有人反問,美國大型科技公司收集大家的資料已經二十五年,為什麼送去中國就特別有問題;也有歐洲使用者問,對一般歐洲人來說,送去美國又好在哪裡。abc42 自己的回答很老實,他說沒有人拿得出百分之百的事實答案,他是憑感覺判斷中國比較糟。另一位使用者補充,opencode 也有不送往中國的設定,但他推測這大概只會把沒有其他地區供應商的模型直接停用。
整串讀完,最值得台灣公司照抄的是這一則:
我的程式碼本來就開源,中國早就拿得到了。正式工作上,我們用的是 OpenAI 和 Anthropic 的企業方案。(原文:For my professional work we have entreprise plans with OpenAI / Anthropic)
(Hacker News 使用者 Oxodao 的留言,原文)
他跳過了哪個國家比較可怕的爭論,直接用「這份資料外流了會不會出事」來分。個人開源專案送去哪裡都無所謂,公司的程式和客戶資料走有企業合約的管道。這個切法不需要任何立場,哪一家公司都能照著做。
自己的機器跑得動嗎
Apple 那串討論的是用 MLX 在 Mac Studio 上跑大型開源模型,其中一則回報了 DeepSeek 的數字:
補充一下,一台 256GiB 記憶體的 M5 Ultra 跑 DeepSeek 4.1 Flash 0910 版沒問題,讀入大約每秒 3,200 個 token,輸出大約每秒 45 個 token。(原文:single M5 Ultra with 256GiB runs DeepSeek 4.1 Flash 0910 just fine)
(Hacker News 使用者 liuliu 的留言,原文)
要注意他跑的是上一版 0910,而且 763B 參數要塞進 256GiB,一定是壓縮過(量化)的版本。底下有人問記憶體這麼小是不是得壓到很低的位元,一般認為低於 4 位元體驗會打折;liuliu 回說這類 MoE 模型,尤其本來就用低位元訓練的,比小模型或密集模型更耐得住壓縮。也有人提到把部分專家放到 SSD 上可以用更小的記憶體跑,他則提醒這樣讀入會明顯變慢。每秒 45 個 token 給一個人用很夠,要給全公司二三十個人同時用,就是另一回事了。
對台灣公司的意義:先看資料走哪一條路
美國工程師在爭的是信任哪個國家,台灣這邊已經有一條政府畫好的線。數位發展部在 2025 年 1 月 31 日的公告要求公務機關與關鍵基礎設施等限制使用 DeepSeek,對象包括中央與地方機關、公立學校、公營事業、行政法人、自行或委外營運的公眾場地、關鍵基礎設施提供者,以及政府捐助的財團法人,理由是它的運行「涉跨境傳輸及資訊外洩等資安疑慮」。行政院在 2 月 3 日再宣布公務機關全面禁用,列出著作權、模型訓練存有「思想審查、限制等資料偏異」、資料上傳中國的風險尚未釐清、個資保護四項疑慮;學術研究的例外是報准後使用,並建議用不含個資的電腦單機下載、斷網使用。
一般民間公司不在這兩份公告的範圍內,所以問題回到公司自己:資料會去哪裡、出事時適用哪裡的法律。DeepSeek 自己的文件回答了一半。隱私權政策(2026 年 2 月 10 日更新)寫明會在中華人民共和國直接收集、處理與儲存個人資料,範圍包括輸入的文字、上傳的檔案與對話紀錄,使用者有權拒絕資料被拿去訓練模型。開放平台服務條款(2026 年 4 月 29 日生效)則沒有寫 API 請求在哪裡處理,只寫明條款適用中國大陸法律,爭議由杭州 DeepSeek 公司登記地的法院管轄。
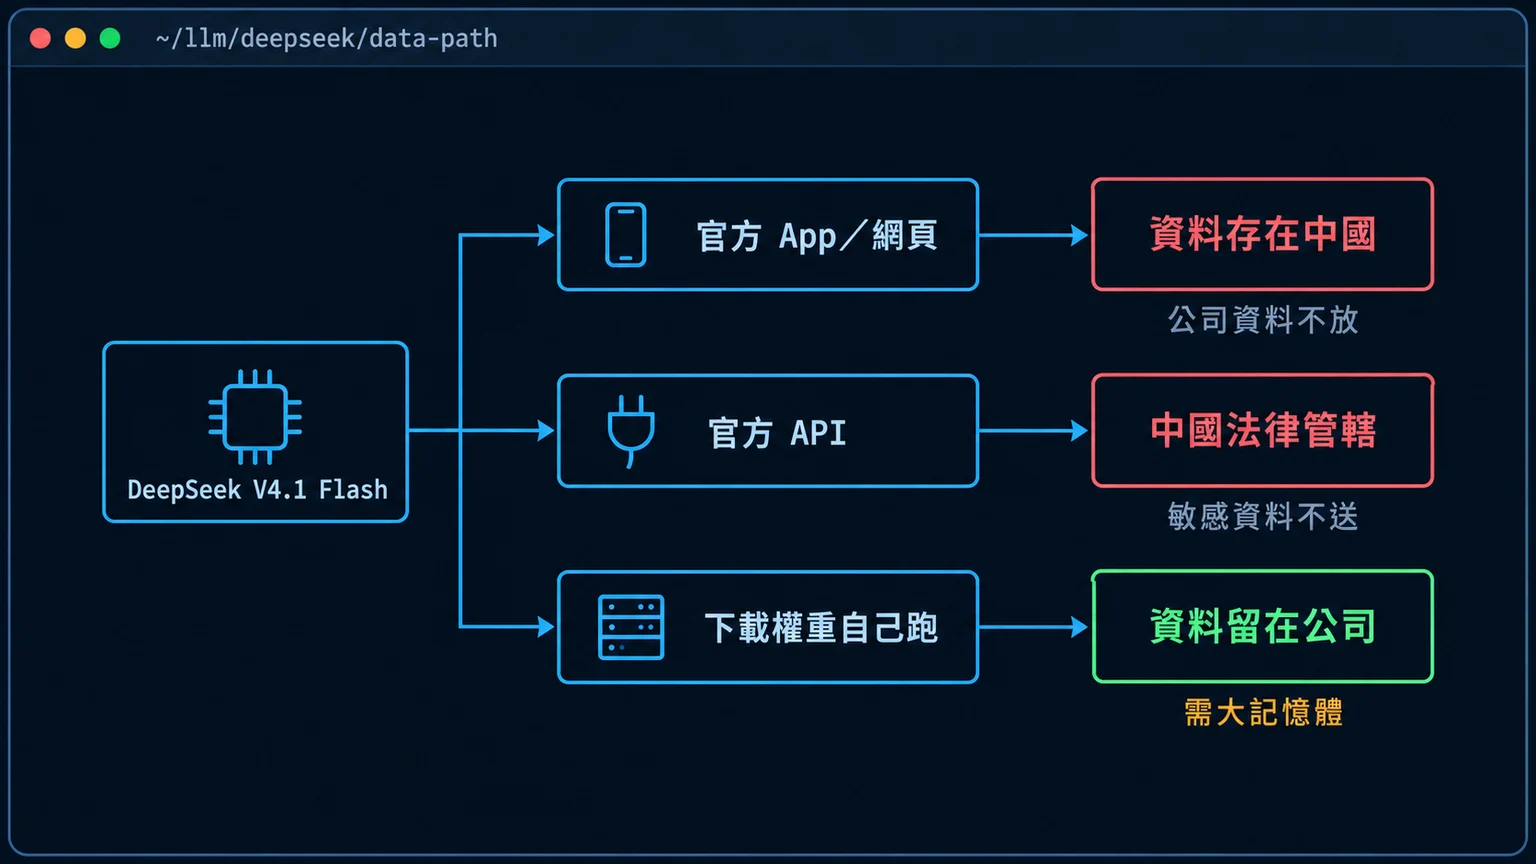
圖:三條路的差別在資料去哪裡,以及出事時適用哪裡的法律
把三條路並排看比較清楚:
| 使用方式 | 資料去向 | 適用的規則 | 適合放什麼 |
|---|---|---|---|
| 官方 App/網頁 | 依隱私權政策存放在中國 | DeepSeek 隱私權政策 | 公開資料、個人學習,不放公司文件與客戶個資 |
| 官方 API | 條款沒寫處理地點,社群回報請求送往中國 | 中國大陸法律、杭州的法院管轄 | 已公開或去識別化的內容,例如公開網頁的摘要 |
| 下載權重自己跑 | 留在自己的機器或自己選的雲端機房 | 公司自己的資安規範與 MIT 授權 | 內部文件也可以,但算力、更新與監控都要自己負責 |
表格少了一欄,就是模型本身說出來的內容。行政院提到的思想審查疑慮,不會因為把權重搬回自己機房就消失,那是訓練時就決定的。內部摘要、寫程式這類工作影響不大;要拿去對外回答客人、寫行銷文案,上線前至少拿幾題跟台灣有關的問題測一次,例如地址裡的國別欄位、公司所在地與節日的寫法,看它的預設說法是不是你要的。AI 客服能做到哪裡、哪些事不該交給它,我們在〈Claude 能做客服到什麼程度〉整理過,換成任何模型,那些界線都一樣適用。
該不該跟:三種團隊的判斷
用 AI 寫程式的團隊與接案者
個人專案、開源專案想試,現在就可以試,社群對它寫程式的評價確實不錯。公司的程式碼與客戶的系統,照 Oxodao 的切法走有企業合約的管道。我們在〈地端模型還是雲端 Copilot〉寫過自己的分層:最敏感的商業邏輯與含個資的開發用地端模型,要送雲端的先過一層過濾,把金鑰與個資遮掉。DeepSeek 的權重可以下載,剛好能放進地端那一層,前提是你有跑得動它的機器。
手上有政府、公立學校或關鍵基礎設施客戶的接案者要多想一步。公告管的是機關本身,但交付的系統如果在背後呼叫 DeepSeek 的 API,很難說服對方的資安窗口,提案前就問清楚,比驗收時被退件好。主力寫程式的模型也不必急著換,我們在〈Gemini 4 Argon 值得換嗎〉說過,發表第一週先讓新模型接旁邊的工作,等社群把問題抓得差不多再評估。三大寫程式 Agent 本身怎麼選,可以看〈Antigravity、Claude Code、Codex 完整比較〉。
想壓低 API 成本的產品團隊
這群人最有理由認真看 DeepSeek。量大的分類、摘要、資料清理,用它的離峰價跑很划算。做法上我們不建議整套換過去,比較穩的是模型路由:不敏感、量大、可以容錯的工作分給便宜模型,關鍵判斷留給原本的模型。這套分工的成本算法寫在〈LLM 帳單越用越貴怎麼救〉,要讓程式自動挑模型,可以參考 jev-router 的思路。資料敏感又想要這個價位,就得算自架的帳:機器、電費、維運人力,再加上前面 liuliu 那種每秒幾十個 token 的速度夠不夠你的用量。
不寫程式的中小企業
公司已經有 ChatGPT、Claude 或 Gemini 的企業方案,就沒有必要為了 DeepSeek 換。比較實際的風險是員工手機上自己裝的 DeepSeek App,與其事後追查,不如在公司的 AI 使用規範裡寫清楚哪些 App 不能放公司資料、客戶個資一律不貼。哪些工具該開、哪些權限千萬別開,可以從〈讓 AI Agent 接上你的工作工具〉那份清單開始;要把模型接進公司自己的系統,就是 AI Agent 開發要先畫清楚的資料流向。
同名換模型,比 DeepSeek 本身更值得記住
回到前面那個細節:deepseek-flash 這個名字沒變,背後的模型在 10 月 17 日換掉了。官方說新版輸出更短、跑更快,對多數人是好事。但如果你的流程依賴它某種固定的輸出格式或長度,昨天還正常的解析程式今天可能就出錯,而且不會跳出任何錯誤訊息,只會看到結果怪怪的。這就像同一支客服專線換了接線人員,聲音聽起來差不多,回答的習慣卻不一樣。
各家 API 都有這種別名指向最新版的設計。接 API 的系統,建議做這幾件小事:
- 設定檔寫明呼叫的模型名稱,每次回應把實際的模型版本記進日誌,出問題時才查得到是哪一版答的。
- 留一份 20 到 30 題的公司真實題目當考卷,模型一更新就重跑一次,比對格式與正確率。
- 能指定日期版本的就指定,升級的時間由自己決定,不讓供應商替你決定。
如果你的 Agent 還會呼叫工具、寫入系統,權限邊界也要一起看,我們在〈AI Agent 駭進 Hugging Face〉整理過帳號、對外網路、金鑰與紀錄四道防線。導入的整體步驟,可以對照〈2026 台灣企業 AI Agent 導入指南〉。
DeepSeek V4.1 Flash 1017 是一次紮實的小改版,速度與價格都讓人心動,社群也證明它寫程式不差。對台灣公司來說,要不要用的分界線不在跑分,在資料:公開或不敏感的工作可以拿它省錢,公司與客戶的資料不走官方 App 與 API,真的想用就自己跑權重。這條線畫好了,下一個又快又便宜的模型出來時,判斷方式也一樣。
延伸閱讀
常見問題
DeepSeek V4.1 Flash 1017 的 API 怎麼計費?
台灣的民間公司可以用 DeepSeek 嗎?
自己下載 DeepSeek 權重來跑,就沒有風險了嗎?
已經用 Claude 或 GPT 寫程式,要換成 DeepSeek 嗎?
這個主題的完整脈絡、選型比較與導入建議,都整理在指南裡。
訂閱免費電子報
把 AI 自動化、企業系統設計與 WordPress / Laravel 開發的真實案例和可直接照做的技巧,整理成電子報寄給你。只寄精選內容、不灌垃圾信,一鍵就能退訂。