Gemini 4 Argon 值得換嗎?社群實測、價格與台灣團隊該不該跟
☰ 目錄 table-of-contents.md
台灣時間 10 月 14 日凌晨,Google 發表 Gemini 4 Argon。天亮後不少公司的 LINE 群組大概都冒出同一串問題:我們已經付了 Google AI Pro 的月費,新模型能直接用嗎?寫程式的 AI 助理要不要從 Claude 換過去?要不要乾脆升級 Ultra?
讀完官方文件、兩份獨立評測和 Hacker News 上一千多則留言,我們的看法分成兩半。Argon 在長文件、財務、法務這類知識工作是目前跑分最高的模型,API 到 11 月 30 日都是推廣價,很值得趁現在拿公司真實文件試一輪。寫程式就沒那麼確定了,第三方排行榜上它仍落後 Claude Opus 5.5,社群也抓到它會卡進推理迴圈,主力寫程式的 Agent 先不要換。只訂 Pro 的人在 Gemini App 裡就用得到,不必為它升級。
這篇寫在發表後第二天,我們還沒有時間拿自家專案完整跑過,所以判斷以 Google 官方資料、第三方測試與社群實測為主,引述的留言都附原文連結。本文價格與規格查證於 2026 年 10 月 15 日,之後若有變動以官方頁為準。
Gemini 4 Argon 發表了什麼:官方說法與查證過的數字
Argon 是 Gemini 4 系列的第一個模型。Google DeepMind 資深副總裁 Koray Kavukcuoglu 在官方發表文裡把它定位成處理「深度工作」的模型,點名的領域是程式、財務、法務、資安與科學,並強調它在 Vals Index(衡量財務、程式、法律與稅務工作表現的綜合指標)排名第一。
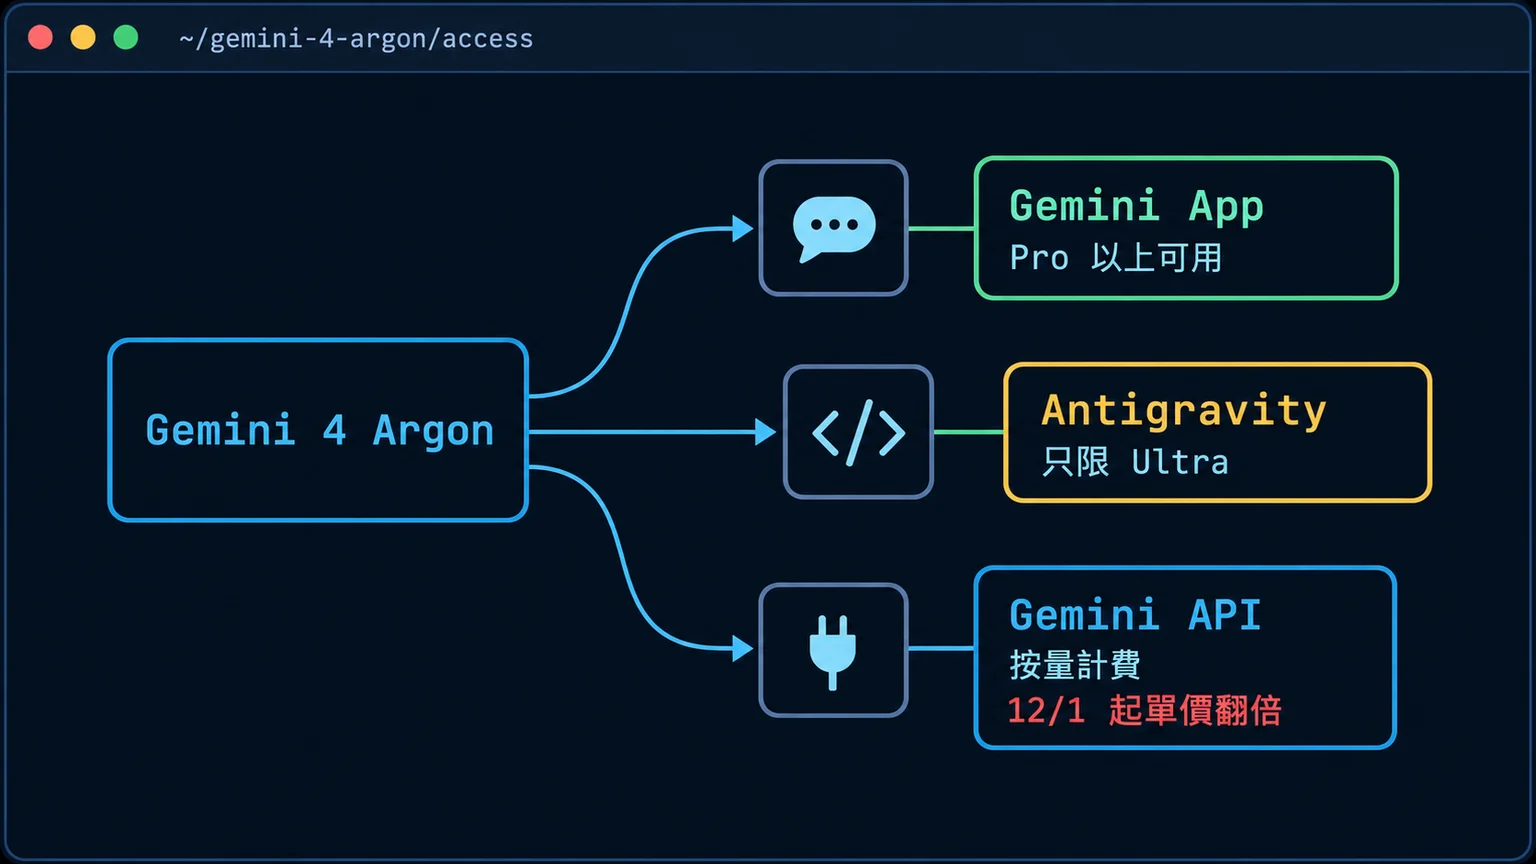
圖:Argon 在三個入口的使用門檻不同,訂閱方案與 API 計費要分開看
跟採購決策直接相關的事實整理如下:
- 上下文長度:透過 Gemini API,輸入加輸出合計上限 100 萬 token。模型卡寫明知識截止在 2026 年 3 月,可以讀文字、圖片、聲音與影片,輸出只有文字。
- API 價格:每百萬輸入 token 2 美元、輸出 10 美元,快取輸入便宜 95%(每百萬 0.10 美元)。這是到 11 月 30 日為止的推廣價,12 月 1 日起變成輸入 4 美元、輸出 20 美元。批次處理是一半價格,官方價格頁也註明 Argon 沒有免費層,模型代號是
gemini-4-argon。 - 個人訂閱:Google 台灣方案頁列出 AI Pro 月費 NT$650、Ultra 5x 月費 NT$3,300、Ultra 20x 月費 NT$6,500,Pro 與 Ultra 都能在 Gemini App 和搜尋的 AI 模式用 Argon。
- 開發工具:Antigravity 與 AI Studio 的訂閱額度只開給 Ultra。AI Studio 方案說明直接寫了 Gemini 4 Argon is not available on the Free or Google AI Pro plans,Antigravity 模型表的 Pro 欄也標成不能用。
- 企業:Gemini for business、API 與 Antigravity 企業方案都可以用。
模型卡的已知限制寫得很直白:可能出現幻覺,也可能偶爾變慢或逾時(原文是 occasional slowness or timeout issues)。這兩點,後面社群的抱怨都對得上。
Hacker News 一千多則留言在吵什麼
發表文在 Hacker News 拿到 1,449 分、1,029 則留言(10 月 15 日時事雷達抓取時的數字),是這週 AI 話題裡討論最熱的一串。讀完一輪,大致可以分成讚嘆它寫得好的、抓到它出包的、拿它跟 Claude 比的,還有一群付了錢卻用不到的人。
讚嘆:答案像一篇用心寫的小論文
我還沒拿它寫程式,但把最近幾個原本問 Claude(多半用 Fable 和 Opus 5.5)的好奇問題丟給它。這是很明顯的一次跳躍,我真的很驚訝。它的回答切中重點、邏輯有結構、寫得清楚,就像一篇用心寫的小論文。(原文:This is a clear step change, I'm genuinely amazed.)
(Hacker News 使用者 svara 的留言,原文)
他在同一則留言裡說,之後除了寫程式以外的事都要交給 Argon。另一位透過 API 使用的 postalcoder 也最看重它的文字能力,他說 X 上拿 2D 插圖、3D 渲染圖當作模型實力指標,是他最不喜歡的風氣,寫得好的文字不容易爆紅,重要性卻高得多(原文)。
讚嘆的留言裡最具體的一則,來自拿 Argon 解讀自己視網膜 OCT 檢查報告的使用者 sebmellen。他說 ChatGPT 6 Pro 和 Opus 5.5 都沒能講清楚報告的臨床意義,Argon 是第一個把儀器原理、生理機制講明白,還做出互動視覺化的模型。底下馬上有人回了一句很關鍵的話:
你怎麼知道這個解釋是對的,還是只是聽起來很對?
(Hacker News 使用者 bonoboTP 的回覆,見同一串討論的原文)
這個問題剛好有數字可以對照。DeepLearning.AI 的電子報 The Batch 引用 Artificial Analysis 的 AA-Omniscience 測試,Argon 的幻覺率是 15%,GPT-6 Astra 是 51%。低很多,但還不是零。The Batch 的評論也點出一個實務上很要緊的差別:模型拒答時一眼就看得出來,可以轉給人或另一個模型處理;答錯的時候,畫面上沒有任何提示。
抓問題:推理迴圈與失敗率
我們在 100 個尚未被刷爆分數的程式環境裡評估 Gemini 4 Argon,它大約落在 Fable 5 和 Fable 5.1 之間,所以大概落後最前線兩個月。……我們也看到一個新問題,希望他們修掉:這是很久以來第一個被我們抓到陷入無限推理迴圈的接近前線模型。
(Hacker News 使用者 gertlabs 的留言,留言者附上自家評測排行榜,原文)
同一則留言也有肯定的部分。舊版 Gemini 在 Agent 框架裡常常跑得沒效率,他認為 Argon 已經解決這個問題,整體是工程設計、程式分析與對話上接近前線的模型,只是推理區塊偶爾切不乾淨,失敗率比對手高。隨手試用的人也碰到了:
我試的第二個提示,Argon 就卡進迴圈了。這可不是好兆頭。
(Hacker News 使用者 jiggawatts 的留言,原文)
另一位使用者 port3000 接著說,這很像 Google 的老毛病,用 Gemini 夠久的人都碰過那種「她愛我、她不愛我」式的重複迴圈(原文)。對要把模型接進自動流程的團隊來說,這件事比跑分差一兩分更要緊,迴圈會一直吃 token,沒設上限就會直接反映在帳單上。
跟 Claude 比:寫程式還不到換的時候
Gemini 系列在寫程式這件事上,歷來都落後 Anthropic(明顯的領先者)和 OpenAI 最好的模型。Opus 5.5 是目前公認最好的寫程式模型。話說回來,到目前為止 Argon 讓我非常驚豔。……它非常好,也非常快。寫程式能不能跟上,現在說還太早。
(Hacker News 使用者 A_D_E_P_T 的留言,原文)
也有人已經拿它做硬底子的工作。charm137 透過 OpenRouter 用 Argon 檢查 Vulkan 圖形程式碼,形容它是「一頭猛獸」,會毫不猶豫地在程式裡加監測程式碼,把畫面緩衝區輸出成圖檔逐像素比對,還會在著色器裡塗上假色來找錯(原文)。
付了錢卻用不到
莫名其妙,我明明付錢給 Google 買了 AI 方案,他們卻不讓我用最新的模型,反而讓我用競爭對手的 Opus 和 Sonnet 5.5。
(Hacker News 使用者 julianz 的留言,原文)
底下有人回覆說可能是分批上線,他在個人 AI Pro 帳號上直到前一天深夜才在 Antigravity 看到 Argon。這跟官方模型表把 Pro 標成不能用的說法對不上。我們的建議是以官方文件為準,自己登入看一次,不要因為某則留言說看得到就先升級。
機器人那一串:比較少撞到桌子
Google 同一天也發表了 Gemini 4 Argon for Robotics,Hacker News 的另一串討論比較像玩家交流。
我是機器人新手,最近衝動買了一台 Unitree 的人形機器人。……我看到 Opus 和 Astra 撞上桌子、床和各種表面(對,我的光達資料還沒接上),Argon 則會非常小心地避開牆壁和其他物體!
(Hacker News 使用者 comandillos 的留言,原文)
同一串也有人問,有沒有 250 美元左右就能玩的入門選項,動輒 5,000 歐元對嗜好來說太貴(原文)。台灣做自動化設備與 AMR 的廠商可以把這條線放進觀察名單,但目前仍是硬體門檻高、實驗性質重的階段,還談不上導入。
官方跑分和獨立測試,差在誰跑的
Google 在 DeepMind 模型頁放了一張十多項的比較表,Argon 拿下大多數第一。第三方整理網站 emergent.sh 逐列追了分數來源,指出這張表混了不同跑法:Argon 是 Google 用最高思考設定自己跑的,對手的分數多半取自公開排行榜或各家自己的報告。下面挑出跟公司實務最有關的幾項,並標出是誰跑的。
| 測試(官方分類) | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra | 分數來源 |
|---|---|---|---|---|
| Vals Index(知識工作) | 68.9% | 67.0% | 63.1% | 第三方 Vals AI |
| AutomationBench(知識工作) | 51.3% | 42.5% | 41.4% | 第三方 Zapier |
| FrontierSWE v2(Agent 寫程式) | 55.0% | 62.3% | 65.5% | 第三方公開排行榜 |
| Terminal-bench 4.0(Agent 寫程式) | 57.4% | 66.4% | 58.2% | Google 跑 Argon,對手取自排行榜 |
| GraphWalks 256K 到 1M(長上下文) | 84.2% | 66.8% | 71.8% | Google 跑全部模型 |
| Agent's Last Exam(電腦操作) | 39.5% | 38.2% | 34.2% | Google 跑 Argon,對手取自排行榜 |
| Artificial Analysis 智慧指數 | 53 | 58 | 53 | 第三方 Artificial Analysis |
這樣排開來看,Argon 的強項很集中:財務、法律、業務流程這類知識工作,加上 256K 以上的超長文件推理。寫程式的兩項,它都排在 Opus 5.5 與 Astra 後面;由獨立單位統一測的 Artificial Analysis 指數,Argon 和 Astra 同分,落後 Opus 5.5 五分。至於人類盲評的 Arena 文字排行,The Batch 報導 Argon 以 1,525 分排第一,這跟社群讚它寫得清楚的感受一致。
價格是另一個要算清楚的地方。Vals 的模型頁顯示,Argon 跑一輪 Vals Index 的成本是 15.68 美元,Opus 5.5 是 32.14 美元,Sonnet 5.5 是 21.34 美元。頁面沒有說明用哪個價格計算;如果用的是推廣價,12 月 1 日單價翻倍之後,Argon 跟 Opus 5.5 的成本差距會大幅縮小。看到又強又便宜的時候,記得這個便宜有期限。
跟 Antigravity、Claude 和你手上的工具是什麼關係
用 Antigravity 寫程式的團隊,多半訂的是 Pro。我們在〈Antigravity 免費版夠用嗎〉整理過 NT$650 方案的額度,在〈Antigravity 底層用哪個 AI 模型〉也拆過模型怎麼選。這次的變化很單純:模型表上 Pro 能用的仍是 Gemini 3.8 Flash,以及非試用訂閱的 Claude Opus 5.5 與 Sonnet 5.5,Argon 不在其中。換句話說,Pro 用戶這週什麼都不用改。
用 Claude 的團隊,該看的是任務分工。我們在〈GPT-6 Astra 和 Opus 5.5 怎麼選〉主張不要整間公司押一個模型,Argon 出來之後這個主張更站得住:長文件、財務與合約分析可以讓 Argon 上場,寫程式的 Agent 留在 Opus 5.5。今年六月 Fable 5 發表時,我們也是拿大型專案實測兩天才寫心得(見〈Claude 發表 Fable 5〉)。新模型第一週的印象,常常在第二週被迴圈、限額、拒答這些實際問題修正,這次也不會例外。
自己用 API 做 Agent 或系統的團隊,這週最值得做的事是確認換模型在你的系統裡有多便宜。我們在〈Jev 是什麼〉寫過官網導覽員的做法:要帶訪客去哪一頁,交給只做決定的小模型;回答才交給大模型,帶路因此從 10 秒縮到 4 秒。這種拆法在新旗艦一個接一個出來的季節特別划算,要試 Argon,只需要換掉回答那一層,路由與流程都不必重寫。社群對這種路由做法的讚美與質疑,整理在〈工程師社群怎麼看 Jev〉。
另一個提醒來自九月。GPT-6 Astra 剛推出時,我們用它四小時設完一套 CRM,也在四小時內燒完一週的訂閱額度(寫在〈GPT-6 Astra 強在哪裡〉)。新模型第一週最容易低估的,往往是額度和帳單。Argon 有推理迴圈的回報,接 API 時一定要設最大輸出 token 與逾時,下指令的習慣可以參考〈AI 額度老是不夠用〉。
做客服或內部知識庫的團隊,15% 的幻覺率聽起來誘人,但它代表的是比較少亂講,離不會亂講還有距離。答案要能追到公司文件的出處,檢索與引用照樣要做,做法在〈RAG 實戰:替企業打造讀得懂內部文件的專屬 AI 大腦〉;哪些工具該讓 Agent 碰、哪些不該,邊界怎麼設寫在〈用 Tool Use 與邊界設定打造精準的 AI Agent〉。
對台灣公司、接案者和 AI 團隊代表什麼
有一件事官方資料沒提:我們讀到的發表文、模型卡與跑分表,都沒有繁體中文的專項成績,社群讚美的也多半是英文寫作。你的工作如果以中文合約、中文客服對話為主,跑分只能當參考,用自己的文件測過才算數。
其他情況可以照這張表判斷:
| 你的情況 | 建議 | 原因 |
|---|---|---|
| 已經訂 Google AI Pro 的一般同仁 | 直接在 Gemini App 用 | Pro 已包含,不用多付錢 |
| 用 Antigravity 寫程式,方案是 Pro | 先不動 | Pro 用不到 Argon,Opus 5.5 仍可用 |
| 想為了 Argon 升級 Ultra | 多數人不需要 | 月費 NT$3,300 起,就 Argon 而言多的是 Antigravity 與 AI Studio 的使用權 |
| 合約、財報、法規這類長文件工作 | 11 月 30 日前用 API 試 | 知識工作與長上下文領先,推廣價只到月底 |
| 主力寫程式的 Agent | 先不換 | 兩項寫程式測試落後 Opus 5.5,且有迴圈回報 |
| 客服或知識庫問答 | 排進比較名單 | 幻覺率較低,但檢索與引用照做 |
表格裡最值得現在動手的是長文件那一列。推廣價只到 11 月 30 日,剛好夠做一輪小規模比較:挑二、三十份公司真實文件(報價單、合約、財報附註都可以),用同一組問題分別問 Argon 和你現在用的模型,請負責的同事逐題判斷對錯。重點放在誰比較少答錯、答錯時有沒有露出破綻,文筆漂亮反而是其次。測出來 Argon 明顯好,12 月以後的價格也算得過來,再談換;測不出差別,就留在原本的模型,省下遷移與重新驗收的工。
接案者這兩週大概會被客戶問要不要換 Gemini 4。比較誠實的回答是:要看系統有沒有把模型寫死。寫死的系統,每次換模型都是一次小改版;有拆出模型路由的系統,換模型只是改設定再跑一輪驗收。這也是我們做 AI Agent 開發時,一開始就把模型當成可替換零件的原因。真的要換之前,拿〈台灣企業 AI Agent 導入指南〉裡從 PoC 走到落地的路徑對照一遍,比追新模型重要。
至於電腦操作,Argon 在 Agent's Last Exam 小勝,但在 OSWorld 2.0 落後 Astra(69.2% 對 72.6%)。要讓 AI 操作瀏覽器或桌面的團隊,我們在〈GPT-6 Astra 的電腦操作值得交給它嗎〉列過的先試清單一樣適用,這一項還看不出誰穩贏。
整體來看,Argon 在知識工作的跑分上同時贏過 Claude 與 GPT 的最新旗艦,這件事值得認真看待;但它寫程式還沒追上,推理迴圈也還在,推廣價又有期限。對多數台灣團隊,這兩週最划算的做法是用推廣價拿真實文件測一輪,寫程式的流程維持原樣,等 12 月新價格上路、看社群回報的迴圈問題有沒有修掉,再決定要不要把它排進主力。
資料來源與查證日期
- Google:Gemini 4 Argon: Built to solve your hardest problems(發表文、價格與可用管道)
- Google DeepMind:Gemini 模型頁與基準測試表
- Gemini 4 Argon 模型卡(知識截止、已知限制)
- Gemini API 價格頁
- Google AI Studio 訂閱方案說明
- Antigravity 模型表
- Google AI 台灣方案與月費
- Vals AI:Gemini 4 Argon 成績與成本
- The Batch:幻覺率與獨立測試整理
- emergent.sh:各項分數的來源追查
- Hacker News:Gemini 4 Argon 主討論串與Gemini 4 Argon for Robotics 討論串
以上價格、方案與跑分查證於 2026 年 10 月 15 日。Google 的推廣價與訂閱內容變動頻繁,下單前請再看一次官方頁。
延伸閱讀
常見問題
Gemini 4 Argon 要付費才能用嗎?
Google AI Pro 在 Antigravity 裡可以用 Argon 嗎?
公司已經用 Claude 寫程式,要換成 Gemini 4 Argon 嗎?
Gemini 4 Argon 比較不會亂講嗎?
12 月以後 Gemini 4 Argon 的 API 會變多貴?
這個主題的完整脈絡、選型比較與導入建議,都整理在指南裡。
訂閱免費電子報
把 AI 自動化、企業系統設計與 WordPress / Laravel 開發的真實案例和可直接照做的技巧,整理成電子報寄給你。只寄精選內容、不灌垃圾信,一鍵就能退訂。